Công nghệ nhận dạng ký tự quang học (OCR) hiện đang hỗ trợ quét biên lai, xác minh danh tính, tự động hóa hóa đơn, số hóa kho lưu trữ lịch sử và các ứng dụng ghi chú bằng bút cảm ứng. Thị trường OCR dự kiến sẽ đạt 32.90 tỷ đô la vào năm 2030 với tốc độ tăng trưởng kép hàng năm (CAGR) là 14.8% (Grand View Research, 2024), trong đó nhận dạng ký tự thông minh — nhánh đọc chữ viết tay của OCR — phát triển nhanh nhất. Cho dù bạn đang xây dựng hệ thống phân tích tài liệu, phát hiện văn bản trong cảnh hay phiên âm chữ viết tay, tập dữ liệu OCR mà bạn sử dụng để huấn luyện sẽ quyết định độ chính xác tối đa của bạn. Hướng dẫn này bao gồm 22 tập dữ liệu OCR mã nguồn mở miễn phí — bao gồm cả các tập dữ liệu chữ viết tay tốt nhất — được sắp xếp theo trường hợp sử dụng và được cập nhật với các bản phát hành mạnh nhất đến năm 2024.
Các nội dung chính
- OCR (Nhận dạng ký tự quang học): Công nghệ chuyển đổi hình ảnh từ văn bản in, cảnh vật hoặc chữ viết tay thành dữ liệu mà máy tính có thể đọc được.
- Bộ dữ liệu OCR được chia thành năm nhóm: tài liệu/biểu mẫu, văn bản trong cảnh, chữ số/ký tự, chữ viết tay và đa ngôn ngữ.
- Bộ dữ liệu OCR tài liệu Ghi lại các trang có cấu trúc như biểu mẫu và biên lai; bộ dữ liệu văn bản cảnh Ghi lại văn bản “trong môi trường thực tế”.
- IAM, MNIST, ICDAR và SROIE vẫn là những bộ dữ liệu chuẩn OCR được trích dẫn nhiều nhất trong nghiên cứu.
- Điều khoản cấp phép rất khác nhau — hãy xác minh từng bộ dữ liệu OCR trước khi sử dụng cho mục đích đào tạo thương mại.
OCR (Nhận dạng ký tự quang học) là gì?
OCR là công nghệ chuyển đổi các loại tài liệu khác nhau, như tài liệu giấy được quét, PDF hoặc hình ảnh văn bản, thành dữ liệu có thể chỉnh sửa và tìm kiếm được. Nó hoạt động bằng cách:
- Phân tích cấu trúc văn bản trong hình ảnh
- Chia nhỏ văn bản thành các dòng và ký tự
- Chuyển đổi các ký tự trực quan này thành văn bản có thể đọc được bằng máy
Sử dụng phổ biến bao gồm:
- Chuyển đổi tài liệu đã quét thành tệp văn bản có thể chỉnh sửa
- Số hóa sách in
- Trích xuất văn bản từ ảnh
- Chuyển đổi đơn thuốc viết tay sang văn bản kỹ thuật số
- Nhận dạng biển số
Làm thế nào để chọn bộ dữ liệu OCR phù hợp?
Việc lựa chọn bộ dữ liệu OCR phụ thuộc vào bốn yếu tố: loại văn bản, môi trường thu thập, độ chi tiết của chú thích và giấy phép. OCR tài liệu in cần dữ liệu huấn luyện khác với văn bản viết tay hoặc văn bản cong trong khung cảnh. Bộ dữ liệu tài liệu phù hợp với hóa đơn, biểu mẫu và biên lai; bộ dữ liệu văn bản trong khung cảnh phù hợp với biển báo và đọc sản phẩm; bộ dữ liệu chữ viết tay phù hợp với ghi chú, bản thảo và nhập liệu bằng bút cảm ứng. Chú thích cấp độ từ và cấp độ dòng hỗ trợ các quy trình OCR hoàn chỉnh, trong khi các bộ chú thích cấp độ ký tự phù hợp với các tiêu chuẩn phân loại cơ bản. Luôn xác nhận các điều khoản giấy phép, vì một số bộ dữ liệu OCR chỉ dành cho nghiên cứu hoặc yêu cầu đăng ký.
Những bộ dữ liệu OCR tài liệu và biểu mẫu nào là tốt nhất?
Các bộ dữ liệu OCR tài liệu huấn luyện các mô hình để phân tích các trang có cấu trúc như hóa đơn, biểu mẫu, biên lai và giấy tờ tùy thân. Chúng hỗ trợ tự động hóa tài liệu kinh doanh và trích xuất giá trị khóa.
- QUỸ — 199 biểu mẫu được quét và chú thích, với hình ảnh nhiễu và mang tính thực tế. Đây là tiêu chuẩn tham khảo để đánh giá khả năng hiểu biểu mẫu và trích xuất cặp khóa-giá trị.
- SROIE — Bộ dữ liệu biên lai quét ICDAR 2019 gồm khoảng 1,000 biên lai, hỗ trợ phát hiện văn bản, nhận dạng và trích xuất thông tin trong một bộ dữ liệu duy nhất.
- DÂY — Bộ dữ liệu biên lai tổng hợp được xây dựng để phân tích sau khi xử lý OCR, với các nhãn chi tiết ở cấp độ trường để tự động hóa hóa đơn và biên lai.
- XFUND — Phiên bản mở rộng đa ngôn ngữ của FUNSD bao gồm bảy ngôn ngữ (tiếng Đức, tiếng Tây Ban Nha, tiếng Pháp, tiếng Ý, tiếng Nhật, tiếng Bồ Đào Nha, tiếng Trung Quốc), mỗi ngôn ngữ có 199 trang. Lý tưởng cho trí tuệ nhân tạo xử lý tài liệu đa ngôn ngữ.
- DDI-100 — Khoảng 100,000 hình ảnh tài liệu bị biến dạng để phát hiện và nhận dạng trong điều kiện suy giảm chất lượng thực tế như méo, mờ và nhiễu.
Những bộ dữ liệu OCR văn bản cảnh nào tốt nhất?
Bộ dữ liệu OCR văn bản trong cảnh dùng để huấn luyện các mô hình đọc văn bản trong hình ảnh tự nhiên như biển báo, sản phẩm và cảnh đường phố. Chúng rất cần thiết cho việc nhận dạng ký tự quang học trong môi trường thực tế, nơi mà bối cảnh phức tạp.
- Đọc dữ liệu mạnh mẽ của ICDAR — Bộ dữ liệu chuẩn mực đứng sau hầu hết các nghiên cứu về văn bản bối cảnh, bao gồm cả các thử thách về Văn bản Bối cảnh Tập trung và Ngẫu nhiên với các khung giới hạn và bản ghi ở cấp độ từ.
- COCO-Text — Chú thích văn bản quy mô lớn được xếp lớp trên ảnh MS-COCO. Hiệu quả trong việc phát hiện văn bản ở quy mô lớn trong các cảnh tự nhiên.
- Tổng văn bản — Chuyên xử lý văn bản cong và có hướng bất kỳ, một điểm yếu thường gặp của các mô hình OCR cũ.
- SVT (Văn bản hiển thị trên Street View) — Hình ảnh minh họa được lấy từ Google Street View, thường có độ phân giải thấp và chất lượng không đồng đều. Có sẵn thông qua các trang web sao lưu của Papers with Code.
- HierText — Chú thích theo cấp bậc từ đoạn văn đến dòng đến từ, bao gồm cả văn bản viết tay và văn bản in. Hữu ích cho việc nhận dạng ký tự quang học (OCR) có tính đến bố cục.
Những bộ dữ liệu OCR chữ số và ký tự tốt nhất là gì?
Các bộ dữ liệu OCR chữ số và ký tự được dùng để huấn luyện các mô hình nhận dạng các ký hiệu riêng lẻ trong môi trường được kiểm soát. Đây là những điểm khởi đầu tiêu chuẩn cho các mô hình phân loại cơ bản.
- DANH SÁCH — 70,000 hình ảnh chữ số viết tay đen trắng. Đây là phương pháp nhanh nhất để xác thực bộ phân loại chữ số.
- EMNIST — Mở rộng MNIST với 814,255 chữ cái và chữ số viết tay được lấy từ Cơ sở dữ liệu đặc biệt 19 của NIST.
- SVHN (Số nhà hiển thị trên Street View) — Hơn 600,000 hình ảnh số thực tế từ các số nhà. Một bước tiến thiết thực so với MNIST trong điều kiện nhiễu.
- 74K ký tự — 74,107 hình ảnh bao gồm các ký tự tiếng Anh và tiếng Kannada từ ảnh chụp thực tế và phông chữ máy tính.
- Cơ sở dữ liệu đặc biệt NIST 19 — Hơn 810,000 hình ảnh ký tự viết tay từ 3,600 người viết. Đây là nguồn tham khảo cho nhiều tiêu chuẩn nhận dạng ký tự quang học (OCR) tiếng Anh.
Những bộ dữ liệu chữ viết tay nào tốt nhất cho OCR?
Các bộ dữ liệu chữ viết tay được dùng để huấn luyện các mô hình OCR đọc chữ viết thường, chữ in và chữ viết tay cổ. Các bộ dữ liệu chữ viết tay mở mạnh nhất vẫn là những chuẩn mực được trích dẫn nhiều nhất cho việc nhận dạng chữ viết tay (HTR).
- Cơ sở dữ liệu chữ viết tay IAM — Bộ dữ liệu chữ viết tay tiếng Anh chuẩn mực, với 13,353 dòng văn bản từ 657 người viết. Vẫn là bộ dữ liệu chữ viết tay được trích dẫn nhiều nhất trong các nghiên cứu OCR năm 2024–2025.
- IAM-OnDB — Phiên bản trực tuyến ghi lại nét bút của IAM, thu thập dữ liệu quỹ đạo. Bộ dữ liệu chữ viết tay chuẩn mực dành cho nhận dạng bằng bút cảm ứng và máy tính bảng.
- Tài liệu Bentham — Bản sao chép các bản thảo tiếng Anh lịch sử từ triết gia Jeremy Bentham. Chuẩn mực hàng đầu cho nhận dạng ký tự quang học (OCR) chữ viết tay lịch sử, có thể truy cập qua Transkribus.
- GNHK (Bộ sưu tập chữ viết tay GoodNotes) — Bộ dữ liệu năm 2021 gồm các ghi chú viết tay tiếng Anh thực tế không bị ràng buộc. Gần giống với dữ liệu sản xuất lộn xộn hơn là dữ liệu IAM sạch sẽ như trong phòng thí nghiệm.
Đâu là những bộ dữ liệu OCR đa ngôn ngữ và không phải chữ Latinh tốt nhất?
Các bộ dữ liệu OCR đa ngôn ngữ huấn luyện các mô hình trên nhiều hệ chữ viết khác nhau ngoài tiếng Anh, bao gồm tiếng Trung, tiếng Ả Rập và ký hiệu toán học. Đây là những dữ liệu thiết yếu cho việc nhận dạng tài liệu và chữ viết tay trên toàn cầu.
- CASIA-HWDB — Chuẩn mực nhận dạng ký tự quang học (OCR) tiếng Trung Quốc, với 1.17 triệu mẫu ký tự viết tay từ 1,020 người viết.
- KHATT — 1,000 mẫu chữ viết tay tiếng Ả Rập từ 1,000 người viết khác nhau, được quét ở nhiều độ phân giải. Bộ dữ liệu OCR tiếng Ả Rập mở toàn diện nhất.
- CROHME — Cuộc thi nhận dạng biểu thức toán học viết tay trực tuyến: Hơn 10,000 biểu thức với hơn 101 ký hiệu toán học, cả trực tuyến và ngoại tuyến. Cần thiết cho việc nhận dạng ký tự quang học (OCR) phương trình viết tay.
Những sai lầm thường gặp khi sử dụng bộ dữ liệu OCR miễn phí là gì?
Ba sai lầm này thường mắc phải ở hầu hết các đội.
Không khớp miền dữ liệu: việc huấn luyện trên tập dữ liệu IAM hoặc COCO-Text sạch và triển khai trên các hóa đơn bị nhàu nát sẽ dẫn đến độ chính xác thấp.
Tình trạng thiếu bản quyền: một số bộ dữ liệu OCR văn bản cảnh và lịch sử chỉ dành cho mục đích nghiên cứu hoặc yêu cầu đăng ký trước khi sử dụng cho mục đích thương mại.
Những thiếu sót trong chú thích: nhiều bộ dữ liệu OCR thiếu siêu dữ liệu bố cục, hộp giới hạn cấp dòng hoặc nhãn trường mà các hệ thống sản xuất cần.
Hãy hình dung một công ty logistics cỡ trung bình đang tự động hóa việc đọc nhãn vận chuyển. Việc huấn luyện bằng văn bản có sẵn giúp họ đạt được 80% trên các bài kiểm tra chuẩn, nhưng các nhãn thực tế với độ chói và nếp gấp làm giảm tỷ lệ này xuống còn 58%. Để thu hẹp khoảng cách đó, cần phải chú thích dữ liệu mục tiêu cho 6,000 hình ảnh nhãn trong lĩnh vực cụ thể trước khi triển khai.
Lợi ích và thách thức của tập dữ liệu nguồn mở
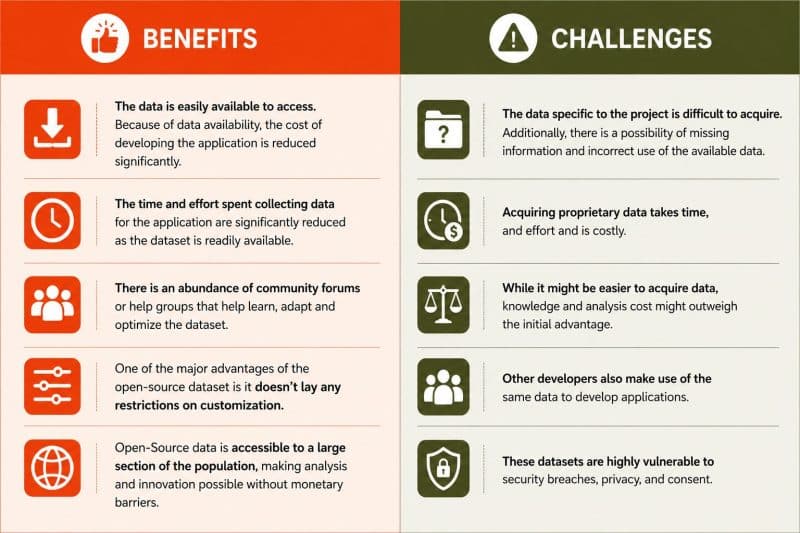
Các doanh nghiệp cần phải phân tích lợi ích và thách thức với nhau để hiểu liệu họ có phải chọn dữ liệu miễn phí sử dụng cho các ứng dụng ML của họ hay không.
Các lợi ích
- Dữ liệu có sẵn để truy cập dễ dàng. Vì có sẵn dữ liệu, chi phí phát triển ứng dụng được giảm đáng kể.
- Thời gian và công sức dành cho việc thu thập dữ liệu cho ứng dụng được giảm đáng kể do bộ dữ liệu luôn sẵn có.
- Có rất nhiều diễn đàn cộng đồng hoặc nhóm trợ giúp giúp tìm hiểu, điều chỉnh và tối ưu hóa tập dữ liệu.
- Một trong những ưu điểm chính của tập dữ liệu nguồn mở là nó không đặt ra bất kỳ hạn chế nào đối với việc tùy chỉnh.
- Dữ liệu nguồn mở có thể truy cập được đối với một bộ phận lớn dân số, giúp cho việc phân tích và đổi mới có thể thực hiện được mà không có các rào cản tiền tệ.
Những thách thức
- Dữ liệu cụ thể cho dự án rất khó để có được. Ngoài ra, có khả năng bị thiếu thông tin và sử dụng sai dữ liệu có sẵn.
- Việc có được dữ liệu độc quyền cần nhiều thời gian, công sức và tốn kém
- Mặc dù có thể dễ dàng hơn để thu thập dữ liệu, kiến thức và chi phí phân tích có thể lớn hơn lợi thế ban đầu.
- Các nhà phát triển khác cũng tận dụng dữ liệu tương tự để phát triển ứng dụng.
- Các tập dữ liệu này rất dễ bị vi phạm bảo mật, quyền riêng tư và sự đồng ý.
Shaip hỗ trợ các dự án nhận dạng ký tự quang học (OCR) và nhận dạng chữ viết tay như thế nào?
Dịch vụ dữ liệu huấn luyện OCR của Shaip kết hợp việc tuyển chọn các bộ dữ liệu mở với việc thu thập dữ liệu tùy chỉnh trên hơn 60 ngôn ngữ, bao gồm tài liệu in, chữ viết tay, biên lai và giấy tờ tùy thân. Quy trình chú thích của Shaip bổ sung các lớp mà các bộ dữ liệu OCR công khai còn thiếu: hộp giới hạn cấp dòng, nhãn cấp trường, kiểm soát chất lượng bản ghi và siêu dữ liệu của người viết.
Kết luận
22 bộ dữ liệu OCR ở trên cung cấp cho bạn nền tảng mã nguồn mở hoàn chỉnh cho việc nhận dạng tài liệu, văn bản trong cảnh, chữ số, chữ viết tay và đa ngôn ngữ cho năm 2026. Hãy bắt đầu với bộ dữ liệu OCR phù hợp với loại văn bản và môi trường thu thập dữ liệu của bạn, xác thực bằng một mẫu dữ liệu thực tế được giữ lại, và dự trù ngân sách cho việc chú thích tùy chỉnh để thu hẹp khoảng cách về lĩnh vực. Sự kết hợp này giúp triển khai nhanh hơn so với việc xây dựng từ đầu.