Dự án Vaani

Dự án Vaani: Vai trò của Shaip trong việc định hình AI đa ngôn ngữ cho Ấn Độ

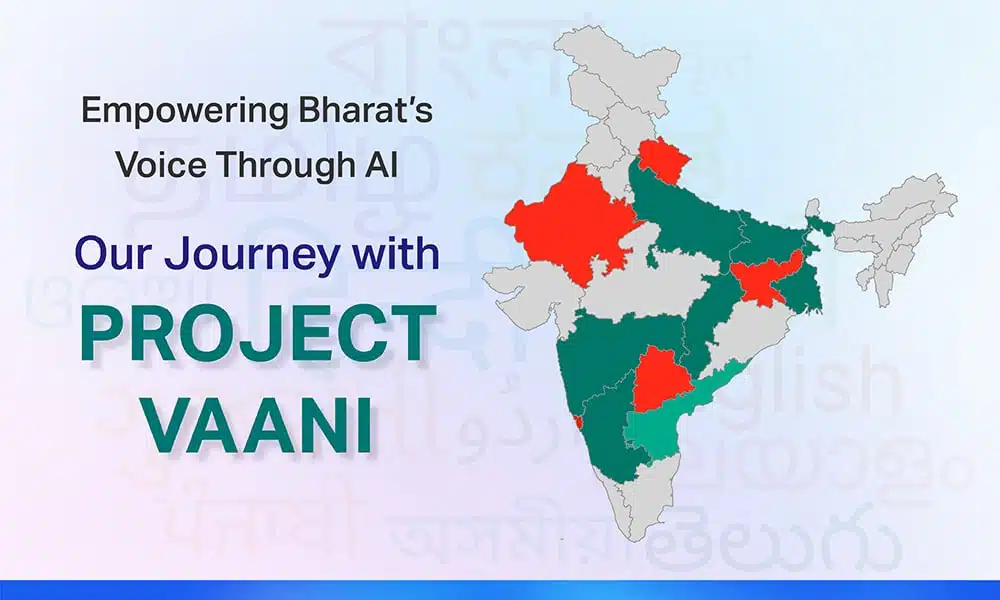
Tại một quốc gia đa dạng về văn hóa và giàu ngôn ngữ như Ấn Độ, việc xây dựng trí tuệ nhân tạo toàn diện bắt đầu bằng việc thu thập các bộ dữ liệu chất lượng cao và mang tính đại diện. Đó là tầm nhìn đằng sau Dự án Vaani — một sáng kiến ​​mã nguồn mở quy mô lớn do ARTPARK , IISc Bengaluru và Google dẫn đầu , nhằm mục đích mang lại tiếng nói cho mọi ngôn ngữ và phương ngữ của Ấn Độ.

Mục tiêu đầy tham vọng là gì? Thu thập hơn 150,000 giờ ghi âm và hơn 15,000 giờ ghi chép từ 1 triệu người trên khắp 773 quận huyện của Ấn Độ.

Là một trong những nhà cung cấp chủ chốt cho sứ mệnh quốc gia này, Shaip đã đóng vai trò then chốt trong việc thu thập dữ liệu giọng nói tự phát, phiên âm và siêu dữ liệu—đặt nền tảng cho các công nghệ giọng nói công bằng, thực sự phản ánh chân thực đất nước Ấn Độ.

Tầm nhìn đằng sau dự án Vaani

Dự án Vaani được thiết kế để thu hẹp khoảng cách về tính toàn diện của AI bằng cách tạo ra bộ dữ liệu đa phương thức, đa ngôn ngữ, mã nguồn mở lớn nhất ở Ấn Độ. Dữ liệu này là nền tảng để phát triển các hệ thống nhận dạng giọng nói, dịch thuật và AI tạo sinh chính xác bằng các ngôn ngữ bản địa của Ấn Độ - nhiều ngôn ngữ trong số đó chưa được đại diện đầy đủ trong hệ sinh thái công nghệ toàn cầu.

Tầm nhìn dài hạn là thúc đẩy các ứng dụng có tác động trong:

Shaip đã giúp xây dựng Bộ dữ liệu giọng nói nguồn mở lớn nhất của Ấn Độ cho Dự án Vaani như thế nào

Shaip được giao nhiệm vụ thu thập 8,000 giờ ghi âm tự phát và 800 giờ ghi âm được kiểm tra thủ công . Trách nhiệm của chúng tôi bao gồm tuyển chọn người tham gia, thu âm, gắn thẻ siêu dữ liệu, điều phối quá trình ghi âm và kiểm soát chất lượng.

8,000 giờ dữ liệu âm thanh tự phát

800 giờ của bản chép tay chất lượng cao

Bản ghi âm từ hơn 400 người bản ngữ mỗi quận, đại diện cho nhiều nhóm tuổi, giới tính và phương ngữ khác nhau.

80 quận, được bao phủ

Sử dụng hình ảnh làm gợi ý để đảm bảo lời nói tự nhiên và phù hợp với ngữ cảnh.

Sau đây là những điểm khiến cách tiếp cận của chúng tôi trở nên độc đáo:

Sự đa dạng cấp huyện

Sự đa dạng cấp huyện

Chúng tôi đã lấy nguồn bản ghi âm từ 80 quận trải dài trên khắp các tiểu bang như Bihar, Uttar Pradesh, Karnataka, Tây Bengal và Maharashtra. Mỗi quận đóng góp 100 giờ dữ liệu âm thanh, đảm bảo cân bằng khu vực. Chúng tôi đã thu hút người bản xứ, đảm bảo đại diện cho giọng địa phương và phương ngữ thường bị bỏ qua trong các tập dữ liệu AI chính thống.

Biểu diễn ngôn ngữ và nhân khẩu học

Biểu diễn ngôn ngữ và nhân khẩu học

Chúng tôi đã lấy nguồn bản ghi âm từ 80 quận trải dài trên khắp các tiểu bang như Bihar, Uttar Pradesh, Karnataka, Tây Bengal và Maharashtra. Mỗi quận đóng góp 100 giờ dữ liệu âm thanh, đảm bảo cân bằng khu vực. Chúng tôi đã thu hút người bản xứ, đảm bảo đại diện cho giọng địa phương và phương ngữ thường bị bỏ qua trong các tập dữ liệu AI chính thống.

Lời nói được nhắc nhở bằng hình ảnh

Để kích thích vốn từ vựng tự phát và tự nhiên, người tham gia được cho xem 45–90 hình ảnh mỗi buổi và được yêu cầu mô tả chúng. Người tham gia được nhắc nhở sử dụng nhiều hình ảnh khác nhau—từ biểu tượng văn hóa đến đồ vật hàng ngày—để gợi ra những phản ứng tự nhiên, tự phát bằng ngôn ngữ mẹ đẻ của họ. Điều này đảm bảo các bản ghi phản ánh lời nói trong thế giới thực, theo ngữ cảnh—cần thiết để đào tạo các hệ thống NLP nâng cao.

Tiêu chuẩn phiên âm chất lượng cao

Tiêu chuẩn phiên âm chất lượng cao

Chỉ có 10% dữ liệu giọng nói được phiên âm—tương đương với 800 giờ. Phiên âm được thực hiện bởi các nhà ngôn ngữ học địa phương trong bán kính 20–50 km tính từ người nói, đảm bảo sự quen thuộc với phương ngữ và sắc thái. Kiểm tra lớp thứ hai đảm bảo tỷ lệ lỗi từ (WER) <5%.

Đảm bảo chất lượng nghiêm ngặt

Dữ liệu âm thanh phải đạt tiêu chuẩn cao: không có tiếng ồn nền, tiếng vọng, rung điện thoại hoặc méo tiếng. Âm thanh được ghi trong môi trường yên tĩnh, không có tiếng vọng. Các tệp đã trải qua quá trình xem xét nghiêm ngặt để đáp ứng các hướng dẫn về độ rõ của giọng nói, mức độ tiếng ồn, độ chính xác của siêu dữ liệu và xác minh người nói. Việc gắn thẻ siêu dữ liệu phải chính xác trên tất cả các tệp và tất cả các bản ghi đều được kiểm tra để căn chỉnh người nói và vị trí.


Những thách thức chúng tôi đã giải quyết

Thành công của chúng tôi là nhờ vào kế hoạch tỉ mỉ, xác thực dựa trên công nghệ và quan hệ đối tác với các nhóm địa phương hiểu rõ sắc thái văn hóa của từng khu vực.

Tác động và ứng dụng

Đóng góp của Shaip không chỉ đẩy nhanh tiến độ của Dự án Vaani mà còn đặt nền tảng cho AI toàn diện ở Ấn Độ. Bộ dữ liệu giọng nói được quản lý đã được sử dụng để xây dựng và tinh chỉnh các mô hình AI cho:

  • Trợ lý giọng nói bản địa
  • Công cụ dịch thuật khu vực
  • Công cụ giao tiếp dễ tiếp cận dành cho người khiếm thị
  • Nền tảng công nghệ giáo dục AI dành cho học sinh nông thôn
  • Y tế từ xa nông thôn
  • Dịch vụ công dân bằng giọng nói
  • Biên dịch và phiên âm thời gian thực

Kết luận

Dự án Vaani là một bước tiến táo bạo hướng tới trí tuệ nhân tạo toàn diện và dễ tiếp cận – và Shaip rất vinh dự được đóng vai trò nền tảng. Công việc của Shaip trong Dự án Vaani khẳng định lại cam kết của chúng tôi trong việc xây dựng các hệ thống trí tuệ nhân tạo có đạo đức, toàn diện, dựa trên sự đa dạng và đại diện. Với hơn 8,000 giờ ghi âm và 800 giờ được phiên âm, chúng tôi tự hào đã đóng góp vào một trong những dự án hòa nhập kỹ thuật số có tầm nhìn xa nhất của Ấn Độ.

Khi Dự án Vaani tiếp tục hướng tới mục tiêu lớn hơn là thu thập hơn 150,000 giờ dữ liệu, chúng tôi sẵn sàng hỗ trợ ranh giới tiếp theo của đổi mới AI hướng đến và dành cho mọi người dân Ấn Độ.

Bạn muốn hợp tác với chúng tôi để xây dựng trí tuệ nhân tạo hiểu được thế giới thực? www.shaip.com

Bạn thấy bài viết này hay? Hãy theo dõi Shaip trên LinkedIn để nhận thêm thông tin cập nhật.

Xã hội Chia sẻ