Thị giác máy tính (Computer Vision - CV) là một lĩnh vực chuyên biệt của Trí tuệ nhân tạo, đang thu hẹp khoảng cách giữa khoa học viễn tưởng và hiện thực. Những tiểu thuyết, phim ảnh và kịch nói từ thế kỷ trước đã kể những câu chuyện hấp dẫn về máy móc nhìn nhận môi trường xung quanh như con người và tương tác với chúng. Nhưng ngày nay, tất cả điều đó đã trở thành hiện thực nhờ các mô hình CV.
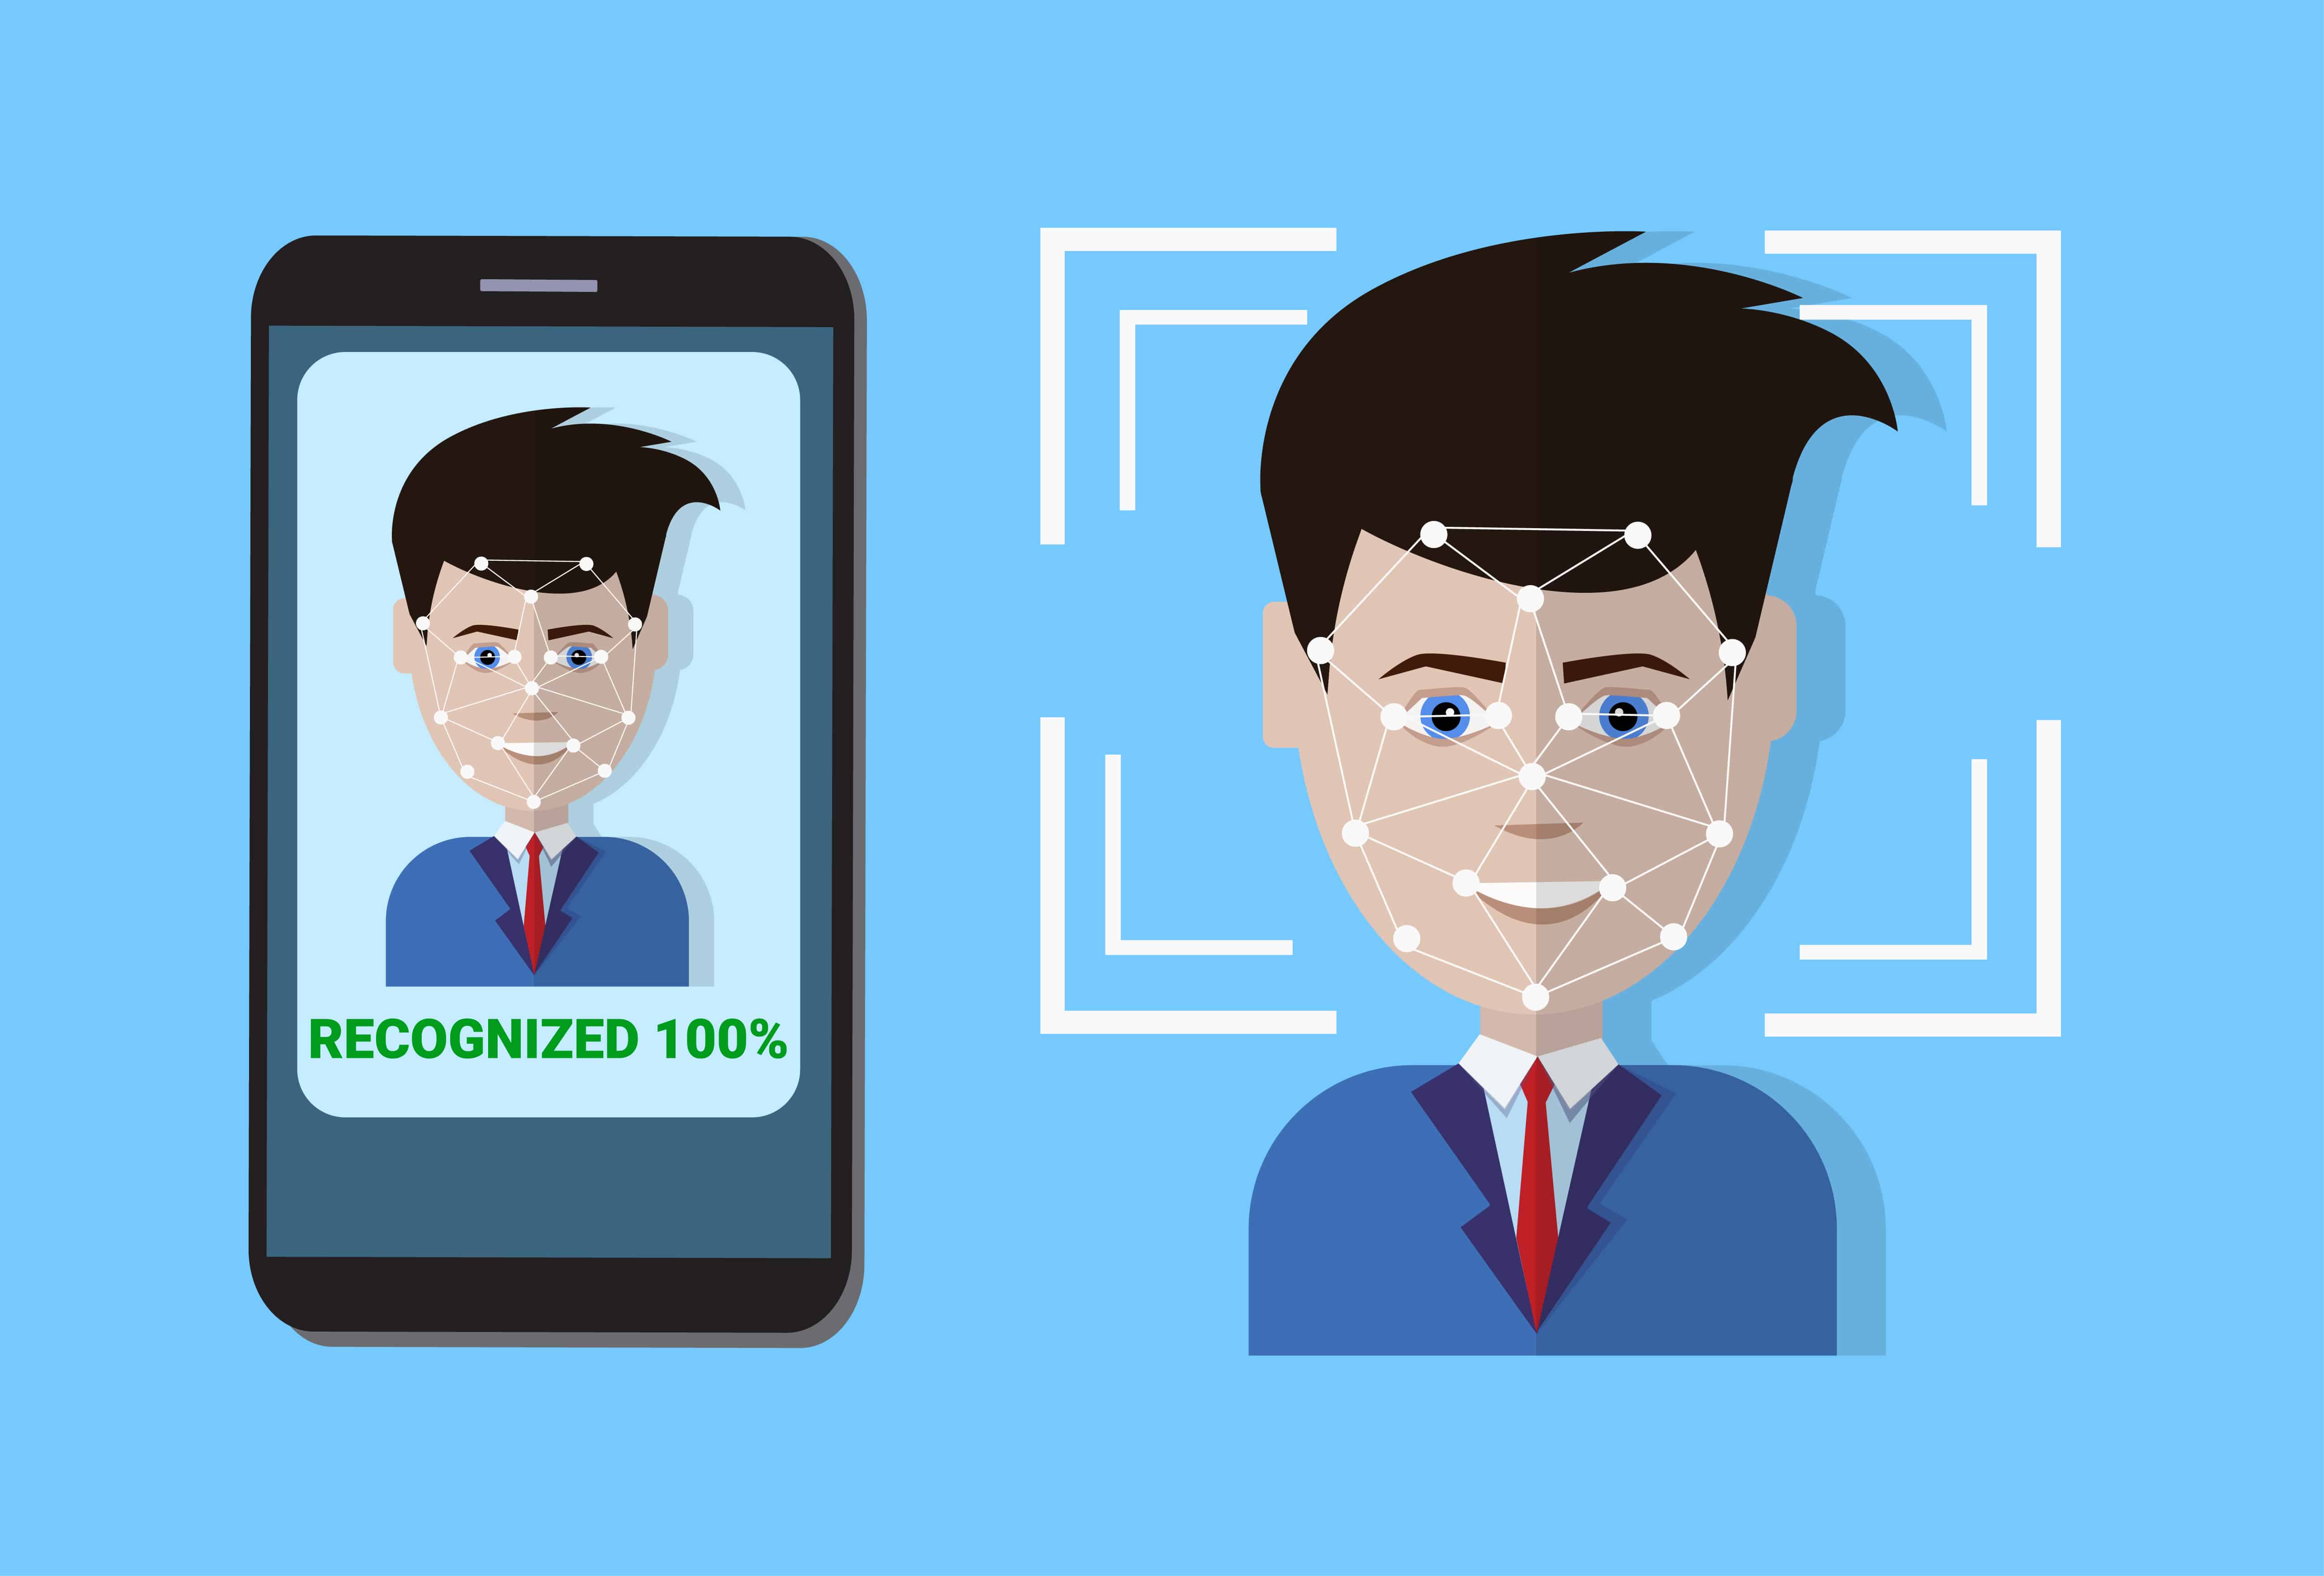
Cho dù đó là một tác vụ đơn giản như mở khóa điện thoại thông minh bằng nhận diện khuôn mặt hay một trường hợp sử dụng phức tạp hơn như chẩn đoán máy móc trong môi trường Công nghiệp 4.0, thị giác máy tính đang thay đổi cuộc chơi trong việc định hình lại các phương pháp vận hành truyền thống. Nó đang mở đường cho độ tin cậy, giải quyết xung đột nhanh chóng và báo cáo chi tiết trong tất cả các trường hợp sử dụng.
Tuy nhiên, mức độ chính xác và độ tin cậy của kết quả mô hình CV phụ thuộc vào chất lượng dữ liệu đào tạo của nó. Chúng ta hãy phân tích kỹ hơn một chút.
Chất lượng dữ liệu đào tạo AI tỷ lệ thuận với đầu ra của mô hình CV
Tại Shaip , chúng tôi luôn nhấn mạnh tầm quan trọng và tính thiết yếu của các bộ dữ liệu chất lượng trong việc huấn luyện các mô hình AI. Khi nói đến các ứng dụng chuyên biệt liên quan đến thị giác máy tính, đặc biệt là thị giác con người, điều này càng trở nên quan trọng hơn.
Sự đa dạng trong các tập dữ liệu là điều cần thiết để đảm bảo các mô hình thị giác máy tính hoạt động theo cùng một cách trên toàn cầu và không biểu hiện sự thiên vị hoặc kết quả không công bằng đối với các chủng tộc, giới tính, địa lý hoặc các yếu tố cụ thể khác do thiếu tập dữ liệu có sẵn để đào tạo.
Để làm rõ hơn tầm quan trọng của sự đa dạng ở con người trong việc huấn luyện các mô hình thị giác máy tính , dưới đây là một số lý do thuyết phục.
- Để ngăn chặn sự thiên vị lịch sử và cải thiện tính công bằng trong việc xử lý con người mà không có bất kỳ sự phân biệt đối xử hoặc thiên vị nào
- Để có hiệu suất mạnh mẽ của các mô hình nhằm đảm bảo thị giác máy tính hoạt động hoàn hảo ngay cả đối với hình ảnh có ánh sáng yếu, độ tương phản kém, biểu cảm khuôn mặt khác nhau, v.v.
- Để thúc đẩy chức năng bao gồm của mô hình cho những người có lối sống và lựa chọn ngoại hình khác nhau
- Để tránh thiệt hại về mặt pháp lý hoặc danh tiếng do hậu quả như nhận dạng sai
- Để cải thiện trách nhiệm trong việc ra quyết định dựa trên AI và nhiều hơn nữa
Làm thế nào để đạt được sự đa dạng trong việc tìm nguồn khuôn mặt người cho các mô hình thị giác máy tính
Sự thiên vị trong dữ liệu huấn luyện thường xảy ra do các yếu tố bẩm sinh hoặc do thiếu dữ liệu đại diện từ nhiều vùng địa lý, chủng tộc và sắc tộc khác nhau. Tuy nhiên, có những chiến lược đã được chứng minh để giảm thiểu sự thiên vị và đảm bảo tính công bằng trong các tập dữ liệu huấn luyện AI . Hãy cùng xem xét những cách chắc chắn để đạt được điều này.

Thu thập dữ liệu theo kế hoạch
Mỗi mô hình thị giác máy tính đều được xây dựng để giải quyết một vấn đề hoặc phục vụ một mục đích nhất định. Việc xác định điều này sẽ giúp bạn hiểu rõ hơn về đối tượng mục tiêu cuối cùng. Khi phân loại họ thành các nhóm đối tượng khác nhau, bạn sẽ có một cẩm nang hướng dẫn để hiểu các chiến lược thu thập dữ liệu.
Sau khi xác định được, bạn có thể quyết định xem mình muốn ưu tiên sử dụng các cơ sở dữ liệu công cộng hay thuê ngoài cho các chuyên gia như Shaip, người sẽ tìm kiếm dữ liệu huấn luyện AI chất lượng cao một cách có đạo đức phù hợp với yêu cầu của bạn.
Tận dụng các loại kỹ thuật tìm nguồn cung ứng khác nhau
Sự đa dạng của con người trong các tập dữ liệu có thể đạt được nhiều hơn nữa bằng cách tận dụng các loại phương pháp lấy dữ liệu khác nhau. Chúng tôi sẽ giúp bạn dễ dàng tiếp cận phương pháp này hơn bằng cách liệt kê chúng ra: