Một mô hình học máy thành công bắt đầu từ dữ liệu huấn luyện chất lượng cao. Nhưng một trong những câu hỏi phổ biến nhất mà các nhóm đặt ra khi bắt đầu một dự án AI là: bao nhiêu dữ liệu huấn luyện là đủ?
Câu trả lời thẳng thắn là không có con số cố định nào phù hợp với mọi dự án. Lượng dữ liệu bạn cần phụ thuộc vào nhiệm vụ, độ phức tạp của mô hình, số lượng lớp, chất lượng dữ liệu, độ chính xác của nhãn và tiêu chuẩn hiệu suất bạn muốn đạt được.
Trên thực tế, cách tốt nhất để ước tính yêu cầu dữ liệu huấn luyện là bắt đầu với một mẫu đại diện, huấn luyện trên các tập con lớn dần và đo lường khi hiệu suất của mô hình bắt đầu ổn định. Điều này giúp các nhóm đưa ra quyết định sáng suốt về chi phí, thời gian, nỗ lực chú thích và kết quả mong đợi.
Trong bài viết này, chúng tôi sẽ phân tích các yếu tố chính ảnh hưởng đến khối lượng dữ liệu huấn luyện, giải thích cách ước tính yêu cầu trong thực tế và chỉ ra những việc cần làm khi bạn cần thêm dữ liệu mà không làm chậm tiến độ phát triển AI của mình.
Tại sao dữ liệu huấn luyện lại quan trọng
Dữ liệu huấn luyện là nền tảng của mọi hệ thống học máy. Cho dù thuật toán có tiên tiến đến đâu, nó chỉ có thể học được các mẫu có trong dữ liệu được sử dụng để huấn luyện. Nếu dữ liệu không đầy đủ, thiên lệch, nhiễu hoặc quá hạn chế, mô hình sẽ gặp khó khăn trong việc khái quát hóa trong thế giới thực.
Dữ liệu huấn luyện mạnh mẽ giúp các đội:
- cải thiện độ chính xác của mô hình
- giảm thiểu sự thiên vị và điểm mù
- ước tính chi phí và tính khả thi của dự án chính xác hơn
- giảm thiểu việc làm lại trong quá trình lặp lại mô hình.
- Xây dựng các quy trình kiểm thử và xác thực đáng tin cậy hơn.
Đây là lý do tại sao việc thu thập, làm sạch, gắn nhãn và xác thực dữ liệu thường chiếm phần lớn công sức trong các dự án AI. Nếu dữ liệu yếu, thì dự đoán cũng sẽ yếu.
Không có con số chung nào cả — nhưng có một cách thực tế để ước tính nó.
Nhiều bài báo cố gắng trả lời câu hỏi này bằng một con số duy nhất. Điều đó hiếm khi hữu ích.
Một mô hình phân loại nhị phân đơn giản có thể hoạt động tốt với tập dữ liệu tương đối nhỏ, trong khi một quy trình tinh chỉnh mô hình ngôn ngữ lớn hoặc một hệ thống thị giác máy tính cho các trường hợp ngoại lệ có thể yêu cầu số lượng ví dụ nhiều hơn đáng kể. Câu hỏi hay hơn không phải là "con số kỳ diệu là bao nhiêu?" mà là:
Lượng dữ liệu huấn luyện chất lượng cao, mang tính đại diện tối thiểu cần thiết để đạt được hiệu suất mục tiêu cho trường hợp sử dụng này là bao nhiêu?
Một cách thực tế để trả lời câu hỏi này là sử dụng đường cong học tập: huấn luyện mô hình trên lượng dữ liệu ngày càng tăng và quan sát mức độ cải thiện hiệu suất sau mỗi bước. Khi sự cải thiện bắt đầu chững lại, bạn sẽ có tín hiệu rõ ràng hơn về việc liệu việc thu thập thêm dữ liệu có đáng để đầu tư hay không. Phương pháp này thường được khuyến nghị trong các quy trình làm việc thực tế của học máy.
7 yếu tố quyết định lượng dữ liệu huấn luyện bạn cần
1. Loại mô hình: Học máy cổ điển so với Học sâu
Loại mô hình có tác động lớn đến yêu cầu dữ liệu. Các mô hình học máy cổ điển như hồi quy logistic, cây quyết định hoặc tăng cường gradient thường hoạt động tốt trên các tập dữ liệu có cấu trúc nhỏ hơn, đặc biệt khi các đặc trưng được thiết kế tốt.
Các mô hình học sâu thường yêu cầu nhiều dữ liệu hơn vì chúng tự động học các đặc trưng và chứa nhiều tham số hơn. Đối với các tác vụ xử lý hình ảnh, âm thanh và ngôn ngữ, các mô hình học sâu thường được hưởng lợi đáng kể từ khối lượng và sự đa dạng dữ liệu bổ sung.
2. Học có giám sát so với học không giám sát
Học có giám sát yêu cầu dữ liệu được gắn nhãn, điều này thường khó khăn và tốn kém hơn trong việc thu thập. Nếu mô hình của bạn cần con người chú thích hình ảnh, phiên âm âm thanh, gắn thẻ thực thể hoặc phân loại tài liệu, thì yêu cầu về dữ liệu phải tính đến cả số lượng và nỗ lực gắn nhãn.
Học không giám sát không yêu cầu dữ liệu được gắn nhãn, nhưng vẫn được hưởng lợi từ các tập dữ liệu lớn và mang tính đại diện. Ngay cả khi không có nhãn, mô hình vẫn cần đủ độ bao phủ để phát hiện các mẫu và cấu trúc có ý nghĩa.
3. Độ phức tạp của nhiệm vụ và số lượng lớp
Bài toán phân loại nhị phân đơn giản rất khác so với bài toán xử lý hình ảnh y tế đa lớp hoặc hệ thống nhận dạng giọng nói đa ngôn ngữ.
Khi độ phức tạp của nhiệm vụ tăng lên, yêu cầu về dữ liệu huấn luyện thường cũng tăng theo vì mô hình cần phải học:
- thêm lớp học
- sự khác biệt tinh tế hơn giữa các loại
- các trường hợp ngoại lệ nhiều hơn
- sự biến đổi theo ngữ cảnh nhiều hơn
Ví dụ, việc phân biệt "mèo" với "chó" dễ hơn nhiều so với việc xác định hàng tá lỗi sản phẩm trông giống nhau về mặt hình ảnh trong các điều kiện ánh sáng, góc máy quay và phông nền khác nhau.
4. Chất lượng dữ liệu và độ chính xác của nhãn
Nhiều dữ liệu hơn không phải lúc nào cũng tốt hơn nếu chất lượng dữ liệu kém.
Một tập dữ liệu nhỏ hơn với nhãn chính xác, phân bố cân bằng và định dạng nhất quán có thể hoạt động tốt hơn một tập dữ liệu lớn hơn nhưng nhiều nhiễu. Nhãn chất lượng thấp, bản ghi trùng lặp, định nghĩa lớp yếu, thiếu siêu dữ liệu và hướng dẫn chú thích không nhất quán đều làm giảm hiệu suất của mô hình.
Trước khi thu thập thêm dữ liệu, các nhóm nên đặt ra các câu hỏi sau:
- Các nhãn có nhất quán không?
- Chúng ta đã bao quát hết tất cả các tình huống quan trọng của người dùng chưa?
- Dữ liệu này có phản ánh đúng điều kiện sản xuất thực tế không?
- Tập dữ liệu huấn luyện, xác thực và kiểm thử đã được tách biệt đúng cách chưa?
Đối với nhiều dự án, việc cải thiện chất lượng dữ liệu mang lại hiệu quả nhanh hơn so với việc chỉ đơn thuần tăng khối lượng dữ liệu.
5. Sự đa dạng, phạm vi bao phủ và sự cân bằng giữa các tầng lớp xã hội
Một mô hình cần học hỏi từ sự biến đổi thực tế mà nó sẽ gặp phải sau khi triển khai. Điều đó có nghĩa là tập dữ liệu cần phản ánh các kịch bản khác nhau, nhóm người dùng, loại thiết bị, giọng nói, môi trường, định dạng tài liệu, điều kiện hình ảnh và các trường hợp ngoại lệ.
Nếu một nhóm hoặc phân khúc nào đó bị thiếu đại diện, mô hình có thể trông chính xác về tổng thể nhưng lại thất bại nghiêm trọng ở các nhóm nhỏ quan trọng. Đó là lý do tại sao sự đa dạng và cân bằng nhóm quan trọng không kém gì quy mô tuyệt đối.
Trong nhiều trường hợp, câu hỏi không phải là "Chúng ta có đủ dữ liệu không?" mà là "Chúng ta có đủ dữ liệu phù hợp không?"
6. Học chuyển giao và các mô hình được huấn luyện trước
Nếu bạn bắt đầu từ một mô hình đã được huấn luyện sẵn, bạn có thể cần ít dữ liệu cụ thể cho từng nhiệm vụ hơn so với việc huấn luyện từ đầu.
Điều này đặc biệt đúng đối với:
- phân loại hình ảnh sử dụng hệ thống xử lý hình ảnh tiên tiến
- Các nhiệm vụ xử lý ngôn ngữ tự nhiên (NLP) sử dụng mô hình dựa trên Transformer.
- các mô hình phát âm được điều chỉnh cho phù hợp với giọng điệu hoặc lĩnh vực mới.
- quy trình thích ứng miền
Học chuyển giao cho phép các nhóm tái sử dụng kiến thức đã học được trên các tập dữ liệu lớn hiện có, điều này có thể giảm đáng kể gánh nặng chú thích dữ liệu. Bài viết gốc đã đề cập đến vấn đề này khá tốt; nên giữ nguyên nhưng cần đưa ra các ví dụ rõ ràng hơn.
7. Chiến lược thẩm định và hiệu suất mục tiêu
Lượng dữ liệu bạn cần cũng phụ thuộc vào mức độ chính xác của mô hình.
Một nguyên mẫu có thể hoạt động với lượng dữ liệu khiêm tốn. Mô hình sản xuất trong lĩnh vực chăm sóc sức khỏe, tài chính, bảo hiểm, ô tô hoặc các môi trường đòi hỏi tuân thủ nghiêm ngặt sẽ cần phạm vi bao phủ mạnh mẽ hơn, nhãn rõ ràng hơn, xác thực tốt hơn và hiệu suất đáng tin cậy hơn trong các trường hợp ngoại lệ. Tỷ lệ lỗi chấp nhận được càng nghiêm ngặt, tập dữ liệu của bạn càng phải mạnh mẽ hơn.
Cách ước tính nhu cầu dữ liệu huấn luyện trong thực tế
Thay vì đoán mò, hãy sử dụng quy trình ước tính có cấu trúc.
Bước 1: Bắt đầu với một bộ dữ liệu thí điểm tiêu biểu
Thu thập một mẫu nhỏ hơn nhưng mang tính đại diện cho không gian vấn đề. Bao gồm các lớp, định dạng, loại người dùng quan trọng và các biến thể thực tế.
Bước 2: Phân chia dữ liệu đúng cách
Tạo các bộ dữ liệu huấn luyện, xác thực và kiểm thử riêng biệt. Đảm bảo bộ dữ liệu kiểm thử phản ánh điều kiện sản xuất và không bao giờ được sử dụng trong quá trình huấn luyện.
Bước 3: Huấn luyện trên các mẫu dữ liệu ngày càng lớn hơn
Huấn luyện mô hình bằng cách sử dụng các phần dữ liệu tăng dần, chẳng hạn như 10%, 20%, 40%, 60%, 80% và 100%.
Bước 4: Vẽ biểu đồ đường cong học tập
Theo dõi các chỉ số hiệu suất như độ chính xác, điểm F1, độ thu hồi, độ chính xác hoặc các thước đo chất lượng cụ thể cho từng tác vụ khi kích thước tập dữ liệu tăng lên.
Bước 5: Tìm kiếm cao nguyên
Nếu hiệu suất mô hình cải thiện đáng kể khi có nhiều dữ liệu hơn, có lẽ bạn cần thêm dữ liệu. Nếu sự cải thiện chững lại, điểm nghẽn của bạn có thể không còn là khối lượng dữ liệu nữa — mà có thể là chất lượng nhãn, thiết kế tính năng, lựa chọn mô hình hoặc sự mất cân bằng lớp.
Bước 6: Xem xét hiệu suất ở cấp độ phân khúc
Kiểm tra hiệu suất của mô hình không chỉ tổng thể mà còn trên các lớp quan trọng và các trường hợp ngoại lệ. Một mô hình có thể đạt hiệu suất ổn định tổng thể nhưng vẫn hoạt động kém hiệu quả trên các phân khúc thiểu số. Phương pháp này cung cấp cho các bên liên quan một ước tính thực tế hơn về lượng dữ liệu bổ sung cần thu thập.
Làm thế nào để biết khi nào bạn đã có đủ dữ liệu huấn luyện?
Bạn có thể đã có đủ dữ liệu khi:
- Hiệu suất của mô hình chỉ cải thiện một cách không đáng kể khi bổ sung thêm dữ liệu.
- Kết quả kiểm định ổn định qua nhiều lần chạy hoặc nhiều lần lặp.
- Các lớp quan trọng đều có kết quả học tập chấp nhận được, chứ không chỉ riêng lớp đa số.
- Hiệu năng được duy trì trên một bộ dữ liệu thử nghiệm sạch, chưa bị chỉnh sửa.
- Các lỗi còn lại chủ yếu là do nhiễu nhãn hoặc sự mơ hồ hơn là do thiếu ví dụ.
Bạn có thể cần thêm dữ liệu khi:
- Quá trình học hỏi vẫn đang tiếp diễn.
- Các lớp hiếm có hiệu suất kém
- Mô hình này thất bại trong các biến thể thực tế phổ biến.
- Kết quả dao động rất nhiều giữa các lần chạy.
- Hiệu năng kiểm thử giảm mạnh so với hiệu năng xác thực.
Cách giảm thiểu yêu cầu dữ liệu huấn luyện
Đôi khi thách thức không nằm ở thiết kế mô hình mà là sự khan hiếm dữ liệu, ngân sách hoặc thời gian đưa sản phẩm ra thị trường. Trong những trường hợp đó, các nhóm có thể giảm sự phụ thuộc vào khối lượng dữ liệu khổng lồ bằng các chiến lược phù hợp.
Tăng cường dữ liệu
Tăng cường dữ liệu tạo ra các ví dụ huấn luyện mới từ dữ liệu hiện có. Trong thị giác máy tính, điều này có thể bao gồm cắt xén, xoay, lật hoặc điều chỉnh độ sáng. Trong xử lý ngôn ngữ tự nhiên và giọng nói, việc tăng cường dữ liệu cần phải cẩn thận hơn, nhưng các phép biến đổi có kiểm soát vẫn có thể hữu ích.
Nếu sử dụng đúng cách, kỹ thuật tăng cường dữ liệu sẽ cải thiện độ bền vững và giúp mô hình khái quát hóa tốt hơn. Nếu sử dụng sai cách, nó có thể gây nhiễu hoặc đưa ra các ví dụ không thực tế.
Chuyển giao học tập
Học chuyển giao cho phép bạn điều chỉnh một mô hình hiện có cho một nhiệm vụ mới thay vì phải huấn luyện từ đầu. Đây thường là một trong những cách hiệu quả nhất để giảm yêu cầu về dữ liệu huấn luyện.
Người mẫu được đào tạo trước
Các mô hình được huấn luyện trước, chẳng hạn như các mô hình xử lý ngôn ngữ tự nhiên (NLP) kiểu BERT hoặc các hệ thống xử lý hình ảnh đã được thiết lập, có thể cung cấp những điểm khởi đầu vững chắc. Thay vì học mọi thứ từ đầu, mô hình bắt đầu với những kiến thức có sẵn hữu ích.
Học tập tích cực
Nếu việc gắn nhãn tốn kém, học tập chủ động có thể giúp ưu tiên các ví dụ cung cấp nhiều thông tin nhất trước. Điều này cải thiện hiệu quả chú thích và có thể giảm số lượng nhãn cần thiết để đạt được hiệu suất hữu ích.
Dữ liệu tổng hợp
Dữ liệu tổng hợp có thể hữu ích khi dữ liệu thực tế khan hiếm, nhạy cảm hoặc khó thu thập, đặc biệt trong các lĩnh vực như chăm sóc sức khỏe, tài chính, hệ thống tự động và mô phỏng các trường hợp ngoại lệ. Tuy nhiên, nó nên bổ sung chứ không phải thay thế một cách mù quáng dữ liệu thực tế, mang tính đại diện.
Ví dụ thực tế về các dự án học máy với bộ dữ liệu tối thiểu
Mặc dù nghe có vẻ bất khả thi khi một số dự án học máy đầy tham vọng có thể được thực hiện với ít nguyên liệu thô, nhưng một số trường hợp lại đúng đến kinh ngạc. Hãy chuẩn bị để ngạc nhiên nhé.
| Báo cáo Kaggle | phù hợp túi tiền | Ung thư lâm sàng |
| Một khảo sát của Kaggle cho thấy hơn 70% các dự án học máy được hoàn thành với ít hơn 10,000 mẫu. | Chỉ với 500 hình ảnh, một nhóm nghiên cứu tại MIT đã đào tạo một mô hình để phát hiện bệnh lý thần kinh do tiểu đường trong hình ảnh y tế chụp mắt. | Tiếp tục ví dụ về chăm sóc sức khỏe, một nhóm nghiên cứu tại Đại học Stanford đã phát triển được một mô hình phát hiện ung thư da chỉ với 1000 hình ảnh. |
Đưa ra các phán đoán có giáo dục
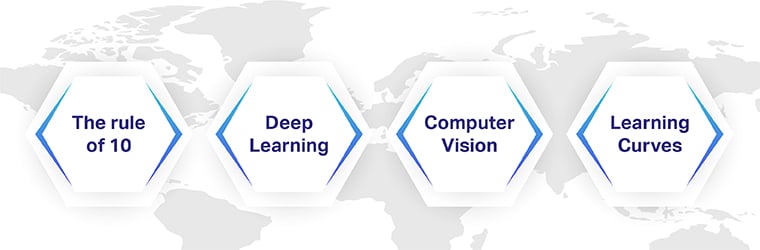
Không có con số kỳ diệu nào liên quan đến lượng dữ liệu tối thiểu cần thiết, nhưng có một số quy tắc ngón tay cái mà bạn có thể sử dụng để đi đến một số hữu tỉ.
Quy tắc 10
Theo kinh nghiệm , để phát triển một mô hình AI hiệu quả, số lượng tập dữ liệu huấn luyện cần thiết phải gấp mười lần số tham số của mô hình, hay còn gọi là bậc tự do. Quy tắc gấp "10" lần này nhằm mục đích hạn chế sự biến động và tăng tính đa dạng của dữ liệu. Do đó, quy tắc này có thể giúp bạn bắt đầu dự án bằng cách cung cấp cho bạn ý tưởng cơ bản về số lượng tập dữ liệu cần thiết.
Học kĩ càng
Phương pháp học sâu giúp phát triển các mô hình chất lượng cao nếu nhiều dữ liệu được cung cấp cho hệ thống. Người ta thường chấp nhận rằng có 5000 hình ảnh được gắn nhãn cho mỗi danh mục là đủ để tạo ra một thuật toán học sâu có thể hoạt động ngang bằng với con người. Để phát triển các mô hình đặc biệt phức tạp, cần có ít nhất 10 triệu mặt hàng được dán nhãn.
Tầm nhìn máy tính
Nếu bạn đang sử dụng học sâu để phân loại hình ảnh, có sự đồng thuận rằng tập dữ liệu gồm 1000 hình ảnh được gắn nhãn cho mỗi lớp là một con số hợp lý.
Học đường cong
Đường cong học tập được sử dụng để chứng minh hiệu suất của thuật toán học máy dựa trên số lượng dữ liệu. Bằng cách có kỹ năng mô hình trên trục Y và tập dữ liệu đào tạo trên trục X, có thể hiểu được kích thước của dữ liệu ảnh hưởng như thế nào đến kết quả của dự án.
Cái giá phải trả khi có quá ít dữ liệu
Khi các nhóm huấn luyện mô hình trên các tập dữ liệu hạn chế, hẹp hoặc thiên lệch, mô hình có thể có vẻ đầy hứa hẹn trong giai đoạn phát triển nhưng lại thất bại trong môi trường sản xuất.
Thiếu dữ liệu có thể dẫn đến:
- quá mức
- khái quát yếu
- dự đoán không ổn định
- Hiệu suất kém ở các lớp thiểu số
- nguy cơ thiên lệch cao hơn
- thời gian lặp lại nhiều hơn sau đó
Nói cách khác, những hạn chế trong dữ liệu huấn luyện của bạn thường trở thành những hạn chế của sản phẩm.
Phải làm gì nếu bạn cần thêm bộ dữ liệu
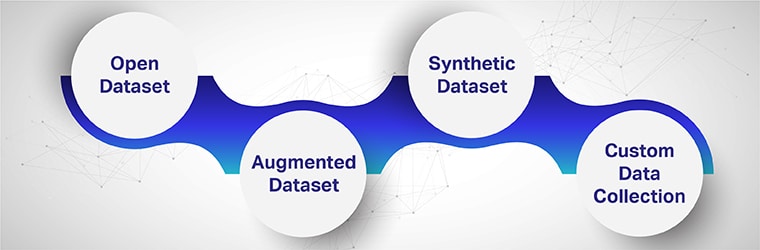
Khi bạn phát hiện ra một khoảng trống dữ liệu, giải pháp không phải lúc nào cũng là "thu thập mọi thứ". Cách tiếp cận thông minh hơn là mở rộng tập dữ liệu một cách chiến lược.
1. Sử dụng các bộ dữ liệu mở một cách cẩn thận
Các bộ dữ liệu mở có thể hữu ích cho việc tạo mẫu hoặc đánh giá hiệu năng, nhưng chúng không phải lúc nào cũng phù hợp để sử dụng trong môi trường sản xuất. Các nhóm nên xem xét nguồn gốc, sự đồng ý, chất lượng, mức độ liên quan và phạm vi bao phủ trước khi phụ thuộc vào chúng.
2. Thu thập dữ liệu tùy chỉnh cho trường hợp sử dụng của bạn
Nếu môi trường mục tiêu rất đặc thù, việc thu thập dữ liệu tùy chỉnh thường là lựa chọn tốt nhất. Điều này đặc biệt đúng đối với các quy trình công việc chuyên sâu về một lĩnh vực cụ thể như trí tuệ nhân tạo trong chăm sóc sức khỏe, trí tuệ nhân tạo đàm thoại, các trường hợp đặc thù của thị giác máy tính và các hệ thống đa ngôn ngữ.
3. Cải thiện dữ liệu hiện có thông qua chú thích
Nhiều nhóm đã có dữ liệu thô nhưng thiếu cấu trúc. Việc chú thích, dán nhãn lại, làm sạch phân loại và đánh giá chất lượng có thể giúp khai thác giá trị nhanh hơn so với việc thu thập các bộ dữ liệu hoàn toàn mới.
4. Cân bằng lại sự đa dạng của các nhóm thiểu số
Nếu hiệu suất yếu ở các hạng mục cụ thể, hãy tập trung thu thập và gắn nhãn vào những khoảng trống có tác động lớn đó thay vì mở rộng toàn bộ tập dữ liệu một cách đồng đều.
5. Thêm dữ liệu tổng hợp hoặc dữ liệu tăng cường khi thích hợp
Khi dữ liệu thực tế bị hạn chế hoặc nhạy cảm, dữ liệu tổng hợp và dữ liệu bổ sung có thể giúp cải thiện phạm vi bao phủ — nhưng cần phải được xác thực cẩn thận so với các phân bố thực tế.
6. Hợp tác với đối tác dữ liệu chuyên biệt
Đối với các nhóm xây dựng hệ thống AI sản xuất quy mô lớn, việc hợp tác với nhà cung cấp có khả năng thu thập, cấp phép, chú thích, xác thực và quản lý dữ liệu huấn luyện chất lượng cao có thể giảm đáng kể rủi ro dự án và đẩy nhanh tiến độ triển khai.
.
Không có con số kỳ diệu nào cho dữ liệu huấn luyện trong học máy. Lượng dữ liệu phù hợp phụ thuộc vào trường hợp sử dụng, loại mô hình, chất lượng dữ liệu, sự đa dạng của lớp, chiến lược xác thực và hiệu suất mục tiêu.
Cách hiệu quả nhất để ước tính nhu cầu dữ liệu huấn luyện là bắt đầu với một mẫu đại diện, đo lường hiệu suất bằng đường cong học tập và mở rộng tập dữ liệu một cách chiến lược dựa trên những điểm mà mô hình vẫn còn gặp lỗi.
Đối với một số dự án, một tập dữ liệu chất lượng cao, quy mô vừa phải có thể là đủ. Đối với những dự án khác, đặc biệt là trong môi trường có rủi ro cao hoặc biến động lớn, sự thành công phụ thuộc vào các tập dữ liệu lớn, được tuyển chọn cẩn thận và chú thích đầy đủ.
Điều quan trọng nhất không chỉ là có nhiều dữ liệu hơn, mà là có được dữ liệu phù hợp.
Bạn có một dự án tuyệt vời trong đầu nhưng đang chờ đợi bộ dữ liệu được thiết kế riêng để huấn luyện mô hình hoặc đang gặp khó khăn trong việc đạt được kết quả như mong muốn từ dự án của mình? Chúng tôi cung cấp các bộ dữ liệu huấn luyện phong phú cho nhiều nhu cầu dự án khác nhau. Hãy khai thác tiềm năng của Shaip bằng cách liên hệ với một trong những nhà khoa học dữ liệu của chúng tôi ngay hôm nay và tìm hiểu cách chúng tôi đã cung cấp các bộ dữ liệu chất lượng cao, hiệu suất vượt trội cho khách hàng trong quá khứ.