Bạn có biết các mô hình AI kết hợp dữ liệu y tế đa dạng có thể tăng độ chính xác dự đoán cho kết quả chăm sóc quan trọng lên 12% hoặc hơn so với các phương pháp tiếp cận đơn phương thức không? Đặc tính đáng chú ý này đang chuyển đổi quá trình ra quyết định chăm sóc sức khỏe để cho phép người chăm sóc đưa ra chẩn đoán và lịch trình điều trị sáng suốt hơn.
Tác động của trí tuệ nhân tạo trong chăm sóc sức khỏe tiếp tục thay đổi hướng đi chung của ngành. Hiện nay, chất lượng và tính đa dạng của các tập dữ liệu đào tạo là những yếu tố quan trọng quyết định hiệu quả của hệ thống AI.
Bộ dữ liệu y tế đa phương thức là gì?
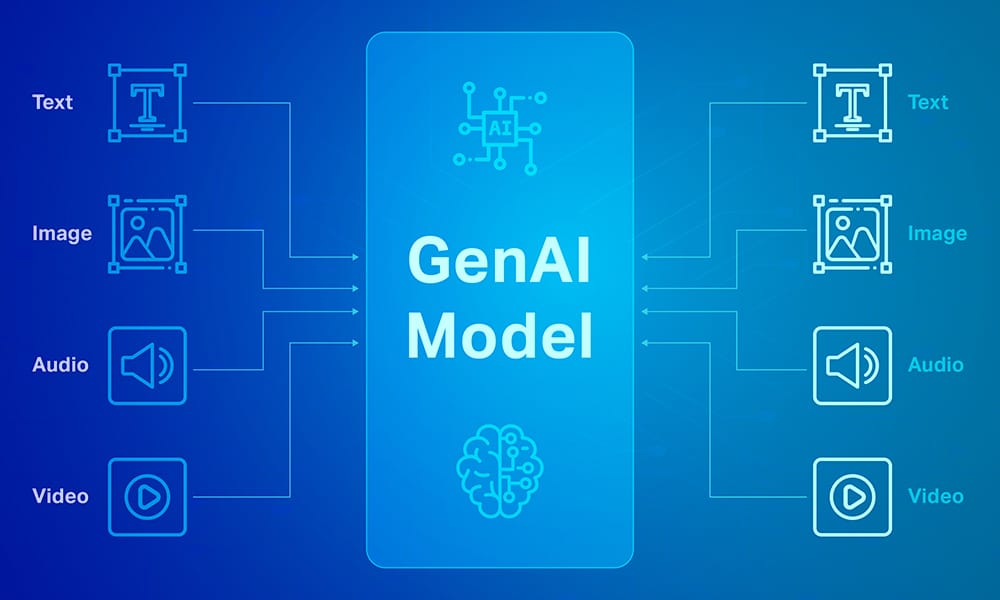
Các tập dữ liệu y tế đa phương thức tập hợp thông tin từ nhiều loại dữ liệu hoặc phương thức khác nhau để cung cấp bức tranh toàn diện về sức khỏe của bệnh nhân mà không một nguồn dữ liệu nào có thể tự cung cấp. Các tập dữ liệu này có thể có sự kết hợp của năm loại thông tin:
Dữ liệu văn bản
Ghi chú lâm sàng, báo cáo bệnh lý, hồ sơ sức khỏe điện tử (EHR) hoặc tiền sử bệnh nhân cung cấp bối cảnh về tình trạng bệnh nhân, quá trình điều trị hoặc diễn biến bệnh và tiền sử bệnh.
Dữ liệu hình ảnh
Chụp X-quang, CT, MRI và siêu âm cung cấp thông tin trực quan về cấu trúc giải phẫu và bất kỳ bất thường nào có liên quan đến chẩn đoán và điều trị.
Dữ liệu âm thanh
Các cuộc trò chuyện giữa bác sĩ và bệnh nhân, lời đọc y khoa và âm thanh của tim và phổi ghi lại những trao đổi bằng lời nói và dấu hiệu sinh học âm thanh có thể cung cấp thông tin chi tiết về mặt lâm sàng.
Dữ liệu bộ gen
Giải trình tự DNA và lập hồ sơ bộ gen chứa thông tin di truyền về các tình trạng di truyền, khả năng mắc bệnh mãn tính và phản ứng với điều trị.
Dữ liệu cảm biến
Dữ liệu đầu ra từ các thiết bị đeo được dùng để theo dõi nhịp tim, huyết áp và mức oxy cung cấp thông tin để theo dõi liên tục bệnh nhân bên ngoài phòng khám.
Khi được tích hợp, các nguồn dữ liệu này cho phép các hệ thống AI kiểm tra mối tương quan giữa các biến để có được thông tin chi tiết sâu hơn và dự đoán tốt hơn so với bất kỳ loại dữ liệu nào.
[Xem thêm: 22 bộ dữ liệu y tế miễn phí và mở dành cho máy học ]
Tầm quan trọng của Bộ dữ liệu y tế đa phương thức đối với sự phát triển của trí tuệ nhân tạo
Bối cảnh nâng cao và hiểu biết đầy đủ
Vì dữ liệu chăm sóc sức khỏe được lưu trữ không đồng nhất trong các hệ thống và định dạng khác nhau, việc tích hợp dữ liệu từ nhiều nguồn cung cấp cho các mô hình AI cơ hội tiếp cận bức tranh lâm sàng hoàn chỉnh hơn. Ví dụ, các mô hình đa phương thức có thể sử dụng cả hình ảnh X quang và ghi chú lâm sàng để hiểu không chỉ cách một tình trạng có thể biểu hiện trực quan mà còn cách bệnh nhân biểu hiện tình trạng theo triệu chứng.
Giải quyết sự phức tạp của chăm sóc sức khỏe
Rất hiếm khi chẩn đoán y khoa hoặc khuyến nghị điều trị dựa trên một điểm dữ liệu duy nhất. Trong thực hành hàng ngày, một phòng khám y khoa sẽ tổng hợp thông tin và bằng chứng trên nhiều điểm dữ liệu (triệu chứng, xét nghiệm và hình ảnh) với tiền sử bệnh nhân trong tâm trí. Sử dụng các tập dữ liệu đa phương thức cho phép trí tuệ nhân tạo phản ánh tốt hơn quá trình ra quyết định được sử dụng trong thực hành thực tế bằng cách tổng hợp các phương thức khác nhau.
Cải thiện đáng kể về độ chính xác
Nghiên cứu liên tục cho thấy các mô hình đa phương thức thường vượt trội hơn các mô hình sử dụng một phương thức duy nhất. Ví dụ, việc kết hợp dữ liệu hồ sơ sức khỏe điện tử với dữ liệu hình ảnh y tế đã chứng minh độ chính xác dự đoán kết quả cao hơn đáng kể, chẳng hạn như liệu bệnh nhân có cần đặt nội khí quản hay không hoặc khi nào cần đặt nội khí quản hoặc khả năng tử vong của bệnh nhân chỉ dựa trên một trong hai nguồn dữ liệu.
Khám phá Y học Cá nhân hóa
Khả năng khám phá các nguồn dữ liệu đa phương thức của AI cho phép nó khám phá ra các mối quan hệ tinh tế, có thể không rõ ràng về mặt lâm sàng, giữa di truyền, lối sống và biểu hiện bệnh, cho phép điều trị thực sự được cá nhân hóa. Điều này đặc biệt hữu ích trong các trường hợp bệnh phức tạp, nơi tính không đồng nhất về biểu hiện có thể còn rõ rệt hơn.
Ứng dụng của Bộ dữ liệu y tế đa phương thức trong chăm sóc sức khỏe
Sau đây là một số ứng dụng quan trọng của bộ dữ liệu y tế trong chăm sóc sức khỏe:
Khả năng chẩn đoán được cải thiện
Các mô hình AI được huấn luyện trên các tập dữ liệu đa phương thức thể hiện khả năng chẩn đoán đáng kể. Ví dụ, Med-Gemini-2D đã đạt được kết quả tiên tiến nhất trong việc trả lời câu hỏi trực quan và tạo báo cáo về phim X-quang ngực, vượt trội hơn các tiêu chuẩn đã thiết lập hơn 12%.
Giải thích hình ảnh y tế 3D
Có lẽ điều ấn tượng nhất là các mô hình AI đa phương thức thậm chí có thể diễn giải các bản quét thể tích 3D phức tạp. Ví dụ, Med-Gemini-3D hiểu và có thể viết báo cáo X quang để chụp cắt lớp vi tính đầu.
Dự đoán sức khỏe
Các phương pháp tiếp cận đa phương thức không chỉ giới hạn ở hình ảnh mà còn mở rộng sang dự đoán kết quả sức khỏe dựa trên dữ liệu, vượt qua các điểm số truyền thống. Điều này bao gồm các kết quả sức khỏe như trầm cảm, đột quỵ và tiểu đường.
Hỗ trợ quyết định lâm sàng
Bằng cách tổng hợp thông tin trên nhiều phương thức, hệ thống AI có thể hỗ trợ bác sĩ lâm sàng bằng một công cụ hỗ trợ quyết định toàn diện. Điều này có thể giúp làm nổi bật các yếu tố dữ liệu quan trọng, gợi ý chẩn đoán tiềm năng và gợi ý các lựa chọn tiềm năng cho phương pháp điều trị phù hợp.
Giám sát và đánh giá từ xa
Hệ thống đa phương thức có thể phân tích dữ liệu từ các thiết bị theo dõi từ xa kết hợp với hồ sơ bệnh án lâm sàng. Điều này cho phép bệnh nhân nhận được đánh giá liên tục về tình trạng của họ bên ngoài các cơ sở chăm sóc sức khỏe truyền thống.
Những thách thức trong việc sử dụng bộ dữ liệu y tế đa phương thức
Mặc dù các tập dữ liệu y tế đa phương thức mang lại triển vọng to lớn, vẫn còn những thách thức đáng kể:
- Truy cập và tích hợp dữ liệu: Việc tiếp cận một tập dữ liệu rộng, đa dạng vẫn còn khó khăn, đặc biệt là đối với các bệnh hiếm gặp. Tương tự như vậy, dữ liệu không đồng nhất với các định dạng, tiêu chuẩn và mức độ chi tiết khác nhau gây ra những khó khăn về mặt kỹ thuật trong việc hài hòa và tích hợp.
- Các vấn đề về quyền riêng tư và bảo mật: Sự kết hợp của nhiều loại dữ liệu khác nhau làm tăng nguy cơ nhận dạng lại bệnh nhân, điều này đòi hỏi phải bảo vệ và tuân thủ các quy định và tiêu chuẩn về quyền riêng tư (ví dụ: HIPAA, GDPR).
- Lắp ráp và độ phức tạp của mô hình giải thích: Các mô hình AI đa phương thức thường rất phức tạp, khiến việc diễn giải lý luận ra quyết định của chúng trở nên khó khăn và đáng sợ.
- Yêu cầu tính toán: Xử lý và phân tích dữ liệu đa phương thức đòi hỏi sức mạnh tính toán đáng kể, làm tăng chi phí phát triển và triển khai mô hình vào các ứng dụng và có khả năng làm giảm khả năng sử dụng.
[Xem thêm: Vì sao bộ dữ liệu chăm sóc sức khỏe lại quan trọng trong việc định hình tương lai của trí tuệ nhân tạo y tế ]
Shaip giải quyết những thách thức này như thế nào
Để giải quyết những thách thức vốn có trong các mô hình và thuật toán dành cho dữ liệu y tế đa phương thức, Shaip cung cấp các giải pháp sau:
Bộ dữ liệu được xử lý trước mở rộng
Với hơn 80% dữ liệu chăm sóc sức khỏe tồn tại ở định dạng không có cấu trúc, không thể truy cập, bộ sưu tập dữ liệu y tế được xử lý trước rộng lớn của Shaip, bao gồm hơn 5.1 triệu hồ sơ y tế ẩn danh và 250,000 giờ dữ liệu âm thanh ghi âm của bác sĩ trên 31 chuyên khoa, cung cấp nền tảng cần thiết cho việc phát triển AI hiệu quả.
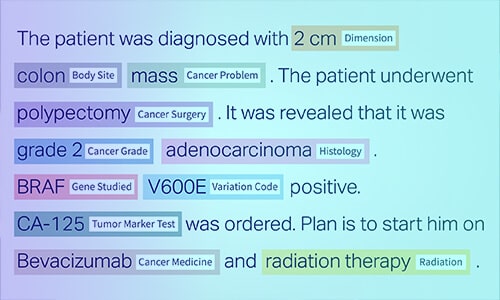
Chú thích và dán nhãn dữ liệu chuyên gia
Dịch vụ chú thích của Shaip cho phép các công cụ AI diễn giải dữ liệu y tế phức tạp. Các chuyên gia trong lĩnh vực của họ có kỹ năng chú thích cả hồ sơ chăm sóc sức khỏe dạng văn bản và hình ảnh để cung cấp dữ liệu đào tạo chất lượng cao, phục vụ cho việc phát triển các mô hình AI.
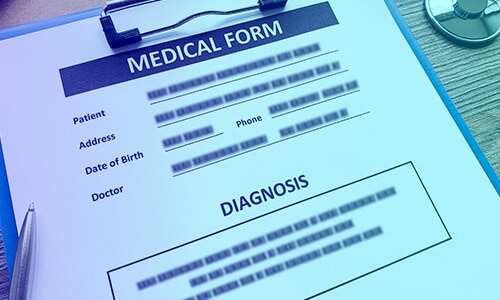
Khả năng xóa nhận dạng mạnh mẽ
Nền tảng ẩn danh độc quyền của Shaip có thể ẩn danh dữ liệu nhạy cảm trong cả tập dữ liệu văn bản và hình ảnh với độ chính xác cực cao. Được các chuyên gia HIPAA xác nhận, các tài liệu này trích xuất các thực thể PHI/PII và sau đó che giấu, xóa hoặc làm mờ các trường đó để cung cấp dữ liệu đã được ẩn danh hoàn toàn, đáp ứng các hướng dẫn tuân thủ của nhà cung cấp và tổ chức.
Bằng cách giải quyết những thách thức nêu trên, Shaip giúp các tổ chức khai thác tiềm năng của các tập dữ liệu y tế đa phương thức và đẩy nhanh quá trình phát triển giải pháp AI giúp chuyển đổi việc cung cấp dịch vụ chăm sóc sức khỏe và mang lại kết quả tốt hơn cho bệnh nhân.