

Nhận dạng thực thể được đặt tên (Named Entrity Recognition - NER) xác định và phân loại các đoạn văn bản vào các danh mục được định sẵn. NER là kỹ thuật xử lý ngôn ngữ tự nhiên (NLP) tìm ra các thông tin quan trọng trong văn bản thuần túy và gắn nhãn cho chúng — một người, một tổ chức, một địa điểm, một ngày tháng hoặc một số tiền. NER là nhiệm vụ NLP định vị các “thực thể được đặt tên” trong văn bản phi cấu trúc và phân loại chúng vào các danh mục được định sẵn. “NER” viết tắt của “Named Entrity Recognition” (nhận dạng thực thể được đặt tên), và nó nằm ở cốt lõi của cách máy móc chuyển đổi ngôn ngữ thô thành dữ liệu có cấu trúc và có thể sử dụng được.
Tại sao điều này lại quan trọng vào thời điểm này? Bởi vì giá trị tiềm ẩn trong văn bản đang bùng nổ. Thị trường xử lý ngôn ngữ tự nhiên (NLP) toàn cầu được định giá 59.70 tỷ USD vào năm 2024 và dự kiến sẽ đạt 439.85 tỷ USD vào năm 2030, với tốc độ tăng trưởng kép hàng năm (CAGR) là 38.7% (Grand View Research, 2024) . Nhận dạng thực thể có tên (NER) là một trong những nhiệm vụ then chốt thúc đẩy sự tăng trưởng đó, âm thầm hỗ trợ các công cụ tìm kiếm, chatbot và các hệ thống xử lý dữ liệu lâm sàng.
Hãy hình dung NER giống như một cây bút dạ quang thực hiện hai nhiệm vụ cùng lúc: nó đánh dấu những từ quan trọng và ghi chú bên lề cho biết mỗi từ là gì. Con người làm điều này một cách bản năng. Nghe thấy “Steve Jobs”, bạn ngay lập tức liên tưởng đến người đó, Apple, California. Máy tính không có bản năng như vậy — nó cần được huấn luyện để nhận biết những nhóm từ đó, và chính quá trình huấn luyện đó là nơi dữ liệu chất lượng đóng vai trò quan trọng.
Trong lĩnh vực chăm sóc sức khỏe, nhận dạng thực thể có cấu trúc (NER) lâm sàng trích xuất các tình trạng bệnh, thuốc, liều lượng, thủ thuật, vị trí giải phẫu, giá trị xét nghiệm và biểu thức thời gian từ các ghi chú không có cấu trúc, sau đó chuẩn hóa chúng theo các tiêu chuẩn như ICD-10-CM, CPT, SNOMED CT và RxNorm để đầu ra có thể đọc được và kiểm toán được bằng máy.
Các nội dung chính
- NER xác định và phân loại các thực thể — người, tổ chức, địa điểm, ngày tháng — trong văn bản.
- "NER" là viết tắt của nhận dạng thực thể được đặt tên, một nhiệm vụ cốt lõi của xử lý ngôn ngữ tự nhiên (NLP).
- Nhận dạng thực thể có tên (NER) hiện đại chủ yếu dựa vào học sâu và các mô hình Transformer như BERT.
- Các hệ thống gắn thẻ như BIO và IOBES đánh dấu điểm bắt đầu và kết thúc của mỗi thực thể.
- Chất lượng của NER phụ thuộc vào dữ liệu huấn luyện chất lượng cao và được chú thích đầy đủ.
- Các lĩnh vực ứng dụng phổ biến: tìm kiếm, chatbot, hồ sơ y tế, tài chính và xem xét pháp lý.
Nhận dạng thực thể được đặt tên (NER) là gì?
Nhận dạng thực thể được đặt tên (NER) là một phần của Xử lý ngôn ngữ tự nhiên. Mục tiêu chính của NER là xử lý dữ liệu có cấu trúc và không có cấu trúc , sau đó phân loại các thực thể được đặt tên này vào các danh mục được xác định trước. Một số danh mục phổ biến bao gồm tên, địa điểm, công ty, thời gian, giá trị tiền tệ, sự kiện, và nhiều hơn nữa.
Tóm lại, NER giao dịch với:
- Nhận dạng/phát hiện thực thể được đặt tên – Xác định một từ hoặc một chuỗi từ trong một tài liệu.
- Phân loại thực thể được đặt tên – Phân loại mọi thực thể được phát hiện vào các danh mục được xác định trước.
Nhưng NER có liên quan như thế nào với NLP?
Xử lý ngôn ngữ tự nhiên giúp phát triển các máy móc thông minh có khả năng trích xuất ý nghĩa từ lời nói và văn bản. Học máy giúp các hệ thống thông minh này tiếp tục học hỏi bằng cách huấn luyện trên một lượng lớn dữ liệu ngôn ngữ tự nhiên.
Nói chung, NLP bao gồm ba loại chính:
- Hiểu cấu trúc và quy tắc của ngôn ngữ - cú pháp
- Tìm ra ý nghĩa của các từ, văn bản và lời nói và xác định các mối quan hệ của chúng - Ngữ nghĩa
- Nhận dạng và nhận dạng các từ đã nói và chuyển chúng thành văn bản - Bài phát biểu
NER giúp trong phần ngữ nghĩa của NLP, trích xuất ý nghĩa của từ, xác định và định vị chúng dựa trên mối quan hệ của chúng.
Đi sâu vào các loại thực thể NER phổ biến
Các mô hình Nhận dạng thực thể có tên phân loại các thực thể thành nhiều loại được xác định trước. Hiểu các loại này rất quan trọng để tận dụng NER hiệu quả. Sau đây là cái nhìn sâu hơn về một số loại phổ biến nhất:
- Người (PER): Xác định tên của cá nhân, bao gồm tên, tên đệm và họ, chức danh và danh hiệu. Ví dụ: Nelson Mandela, Tiến sĩ Jane Doe
- Tổ chức (ORG): Nhận dạng các công ty, tổ chức, cơ quan chính phủ và các nhóm có tổ chức khác. Ví dụ: Google, Tổ chức Y tế Thế giới, Liên hợp quốc
- Vị trí (LOC): Phát hiện vị trí địa lý, bao gồm các quốc gia, thành phố, tiểu bang, địa chỉ và địa danh. Ví dụ: London, Đỉnh Everest, Quảng trường Thời đại
- Ngày (NGÀY): Trích xuất ngày tháng theo nhiều định dạng khác nhau. Ví dụ: 1 tháng 2024 năm 2024, 01-01-XNUMX
- Thời gian (TIME): Xác định các biểu thức thời gian. Ví dụ: 3:00 PM, 15:00
- Số lượng (QUANTITY): Nhận biết số lượng và đơn vị đo lường. Ví dụ: 10 kilôgam, 2 lít
- Phần trăm (PERCENT): Phát hiện phần trăm. Ví dụ: 50%, 0.5
- Tiền (MONEY): Trích xuất các giá trị tiền tệ và tiền tệ. Ví dụ: $100, €50
- Khác (MISC): Một danh mục bao gồm tất cả các thực thể không phù hợp với các loại khác. Ví dụ: Giải Nobel, iPhone 15″
Ví dụ về nhận dạng thực thể được đặt tên
Một số ví dụ phổ biến về phân loại thực thể đã được xác định trước là:
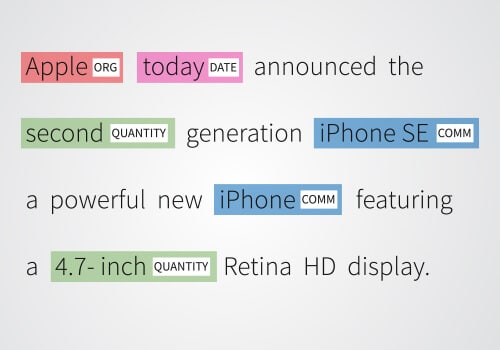
Apple: được ghi nhãn là ORG (Tổ chức) và được tô màu đỏ. Hôm nay: được ghi nhãn là DATE và được tô màu hồng. Thứ hai: được ghi nhãn là QUANTITY và được tô màu xanh lá cây. iPhone SE: được ghi nhãn là COMM (Sản phẩm thương mại) và được tô màu xanh dương. 4.7 inch: được ghi nhãn là QUANTITY và được tô màu xanh lá cây.
Sự mơ hồ trong nhận dạng đối tượng được đặt tên
Phạm trù mà một thuật ngữ thuộc về trực giác khá rõ ràng đối với con người. Tuy nhiên, đó không phải là trường hợp của máy tính - chúng gặp phải các vấn đề về phân loại. Ví dụ:
Manchester City ( Tổ chức ) đã giành chức vô địch Ngoại hạng Anh, trong khi ở câu tiếp theo, tổ chức này được sử dụng theo cách khác. Manchester City ( Địa điểm ) là một cường quốc về dệt may và công nghiệp.
Mô hình NER của bạn cần dữ liệu đào tạo để tiến hành trích xuất thực thể chính xác và phân loại các thực thể được đặt tên dựa trên các mẫu đã học. Nếu bạn đang đào tạo mô hình của mình bằng tiếng Anh Shakespeare, không cần phải nói, nó sẽ không thể giải mã được Instagram. Các mô hình NER được đánh giá bằng cách so sánh các dự đoán của chúng với các chú thích thực tế, là các thực thể được gắn nhãn thủ công chính xác trong tập dữ liệu.
Nhận dạng thực thể được đặt tên hoạt động như thế nào?
Đi sâu vào lĩnh vực Nhận dạng thực thể được đặt tên (NER) sẽ tiết lộ một hành trình có hệ thống bao gồm một số giai đoạn:
-
Mã thông báo
Ban đầu, dữ liệu văn bản được chia thành các đơn vị nhỏ hơn, được gọi là mã thông báo, có thể bao gồm từ từ đến câu. Ví dụ: tuyên bố “Barack Obama là tổng thống Hoa Kỳ” được phân thành các mã thông báo như “Barack”, “Obama”, “was”, “the”, “president”, “of”, “the” và “ HOA KỲ".
-
Phát hiện thực thể
Bằng cách sử dụng sự kết hợp của các nguyên tắc ngôn ngữ và phương pháp thống kê, các thực thể được đặt tên tiềm năng sẽ được chú ý. Nhận biết các mẫu như viết hoa trong tên (“Barack Obama”) hoặc các định dạng riêng biệt (như ngày tháng) là rất quan trọng trong giai đoạn này.
-
Phân loại thực thể
Sau khi phát hiện, các thực thể được sắp xếp thành các danh mục được xác định trước, chẳng hạn như “Người”, “Tổ chức” hoặc “Vị trí”. Các mô hình học máy, được nuôi dưỡng trên các tập dữ liệu được gắn nhãn, thường thúc đẩy sự phân loại này. Ở đây, “Barack Obama” được gắn thẻ là “Người” và “Hoa Kỳ” là “Địa điểm”.
-
Đánh giá theo bối cảnh
Sức mạnh của hệ thống NER thường được khuếch đại bằng cách đánh giá bối cảnh xung quanh. Ví dụ: trong cụm từ “Washington chứng kiến một sự kiện lịch sử”, ngữ cảnh giúp phân biệt “Washington” là một địa điểm chứ không phải là tên một người.
-
Tinh chỉnh sau đánh giá
Sau khi xác định và phân loại ban đầu, quá trình sàng lọc sau đánh giá có thể diễn ra sau đó để cải thiện kết quả. Giai đoạn này có thể giải quyết những điểm mơ hồ, hợp nhất các thực thể có nhiều mã thông báo hoặc sử dụng cơ sở kiến thức để tăng cường dữ liệu thực thể.
Cách tiếp cận được mô tả này không chỉ làm sáng tỏ cốt lõi của NER mà còn tối ưu hóa nội dung cho các công cụ tìm kiếm, nâng cao khả năng hiển thị của quy trình phức tạp mà NER thể hiện.
Các phương pháp nhận dạng thực thể có tên (NER) chính là gì?
Mục tiêu chính của mô hình NER là gắn nhãn các thực thể trong tài liệu văn bản và phân loại chúng. Ba phương pháp sau đây thường được sử dụng cho mục đích này. Tuy nhiên, bạn cũng có thể chọn kết hợp một hoặc nhiều phương pháp. Các phương pháp khác nhau để tạo hệ thống NER là:

Hệ thống dựa trên từ điển
Hệ thống dựa trên từ điển có lẽ là cách tiếp cận NER đơn giản và cơ bản nhất. Nó sẽ sử dụng một từ điển với nhiều từ, từ đồng nghĩa và bộ sưu tập từ vựng. Hệ thống sẽ kiểm tra xem một thực thể cụ thể có trong văn bản cũng có sẵn trong từ vựng hay không. Bằng cách sử dụng thuật toán so khớp chuỗi, việc kiểm tra chéo các thực thể được thực hiện.
Một hạn chế của việc sử dụng phương pháp này là cần phải liên tục nâng cấp bộ dữ liệu từ vựng để mô hình NER hoạt động hiệu quả.
Hệ thống dựa trên quy tắc
Trong cách tiếp cận này, thông tin được trích xuất dựa trên một tập hợp các quy tắc được thiết lập trước. Có hai bộ quy tắc chính được sử dụng,
Quy tắc dựa trên mẫu – Như tên gọi cho thấy, quy tắc dựa trên mẫu tuân theo một mẫu hình thái học hoặc chuỗi từ được sử dụng trong tài liệu.
Các quy tắc dựa trên ngữ cảnh – Các quy tắc dựa trên ngữ cảnh phụ thuộc vào ý nghĩa hoặc ngữ cảnh của từ trong tài liệu.
Hệ thống dựa trên máy học
Trong các hệ thống dựa trên học máy, mô hình thống kê được sử dụng để phát hiện các thực thể. Phương pháp này sử dụng biểu diễn dựa trên đặc trưng của tài liệu văn bản. Bạn có thể khắc phục một số nhược điểm của hai phương pháp đầu tiên vì mô hình có thể nhận dạng các loại thực thể bất chấp những biến thể nhỏ trong chính tả của chúng.
Học kĩ càng
Các phương pháp học sâu cho NER tận dụng sức mạnh của mạng lưới thần kinh như RNN và máy biến thế để hiểu được sự phụ thuộc văn bản dài hạn. Lợi ích chính của việc sử dụng các phương pháp này là chúng rất phù hợp cho các nhiệm vụ NER quy mô lớn với dữ liệu huấn luyện phong phú.
Hơn nữa, họ có thể tìm hiểu các mẫu và tính năng phức tạp từ chính dữ liệu, loại bỏ nhu cầu đào tạo thủ công. Nhưng có một nhược điểm. Những phương pháp này đòi hỏi một lượng lớn sức mạnh tính toán để đào tạo và triển khai.
Phương pháp lai
Các phương pháp này kết hợp các phương pháp tiếp cận như dựa trên quy tắc, thống kê và học máy để trích xuất các thực thể được đặt tên. Mục tiêu là kết hợp điểm mạnh của từng phương pháp đồng thời giảm thiểu điểm yếu của chúng. Phần tốt nhất của việc sử dụng các phương pháp kết hợp là tính linh hoạt mà bạn có được bằng cách hợp nhất nhiều kỹ thuật mà nhờ đó bạn có thể trích xuất các thực thể từ nhiều nguồn dữ liệu khác nhau.
Tuy nhiên, có khả năng là các phương pháp này sẽ phức tạp hơn nhiều so với các phương pháp tiếp cận đơn lẻ vì khi bạn hợp nhất nhiều phương pháp tiếp cận, quy trình làm việc có thể trở nên khó hiểu.
NER được sử dụng ở đâu? Các trường hợp sử dụng và ngành công nghiệp hàng đầu
Tiết lộ tính linh hoạt của công nghệ nhận dạng thực thể được đặt tên (NER).
NER được áp dụng trong nhiều lĩnh vực, từ tài chính đến chăm sóc sức khỏe, chứng minh khả năng thích ứng và tiện ích rộng rãi của nó.
- Chatbot: Hỗ trợ các chatbot như GPT hiểu được truy vấn của người dùng bằng cách xác định các thực thể chính.
- Hỗ trợ khách hàng: Phân loại phản hồi theo sản phẩm, tăng tốc thời gian phản hồi.
- Tài chính: Trích xuất dữ liệu quan trọng từ báo cáo tài chính để phân tích xu hướng và đánh giá rủi ro.
- Chăm sóc sức khỏe: Trích xuất dữ liệu bệnh nhân từ hồ sơ sức khỏe điện tử (EHR).
- Nhân sự: Tối ưu hóa quá trình tuyển dụng bằng cách tóm tắt hồ sơ ứng viên và truyền đạt phản hồi.
- Nhà cung cấp tin tức: Phân loại nội dung thành thông tin có liên quan, giúp tăng tốc độ báo cáo.
- Công cụ khuyến nghị: Các công ty như Netflix sử dụng NER để cá nhân hóa các đề xuất dựa trên hành vi của người dùng.
- Công cụ Tìm kiếm: Bằng cách phân loại nội dung web, NER nâng cao độ chính xác của kết quả tìm kiếm.
- Phân tích tình cảm: Etrích xuất các đề cập về thương hiệu từ các bài đánh giá, thúc đẩy các công cụ phân tích tình cảm.
- Thương mại điện tử: Nâng cao trải nghiệm mua sắm được cá nhân hóa.
- Pháp lý: Phân tích hợp đồng và văn bản pháp lý.
Các thực thể được trích xuất thông qua NER có thể được tích hợp vào biểu đồ kiến thức, cho phép tổ chức và truy xuất dữ liệu tốt hơn.
Ai sử dụng nhận dạng thực thể được đặt tên (NER)?
NER (Named Entity Recognition) là một trong những kỹ thuật xử lý ngôn ngữ tự nhiên (NLP) mạnh mẽ, đã đi vào nhiều ngành và lĩnh vực khác nhau. Các tổ chức thường triển khai hệ thống nhận dạng thực thể được đặt tên để tự động trích xuất thông tin và cải thiện hiệu quả. Sau đây là một số ví dụ:
- Công cụ tìm kiếm: NER là thành phần cốt lõi của các công cụ tìm kiếm hiện đại như Google và Bing. Nó được sử dụng để xác định và phân loại các thực thể từ các trang web và truy vấn tìm kiếm để cung cấp kết quả tìm kiếm có liên quan hơn. Ví dụ, với sự trợ giúp của NER, công cụ tìm kiếm có thể phân biệt giữa "Apple" là công ty so với "apple" là trái cây dựa trên ngữ cảnh. Việc triển khai quy trình NER rất quan trọng để cung cấp kết quả chính xác và có nhận thức về ngữ cảnh.
- Chatbot: Chatbot và trợ lý AI có thể sử dụng NER để hiểu các thực thể chính từ truy vấn của người dùng. Bằng cách đó, chatbot có thể cung cấp phản hồi chính xác hơn. Ví dụ, nếu bạn hỏi "Tìm nhà hàng Ý gần Central Park", chatbot sẽ hiểu "Ý" là loại ẩm thực, "nhà hàng" là địa điểm và "Central Park" là vị trí. Quy trình NER cho phép các hệ thống này trích xuất thông tin có liên quan một cách hiệu quả.
- Báo chí điều tra: Hiệp hội các nhà báo điều tra quốc tế (ICIJ), một tổ chức truyền thông nổi tiếng đã sử dụng NER để phân tích Hồ sơ Panama, một vụ rò rỉ lớn 11.5 triệu tài liệu tài chính và pháp lý. Trong trường hợp này, NER được sử dụng để tự động xác định người, tổ chức và địa điểm trên hàng triệu tài liệu phi cấu trúc, phát hiện các mạng lưới trốn thuế ở nước ngoài ẩn.
- Tin sinh học: Trong lĩnh vực Tin sinh học, NER được sử dụng để trích xuất các thực thể chính như gen, protein, thuốc và bệnh từ các bài báo nghiên cứu y sinh học và báo cáo thử nghiệm lâm sàng. Dữ liệu như vậy giúp đẩy nhanh quá trình khám phá thuốc. Việc đào tạo trước các mô hình trên các tập đoàn y sinh học lớn có thể cải thiện đáng kể hiệu suất của các hệ thống NER trong lĩnh vực chuyên biệt này.
- Giám sát phương tiện truyền thông xã hội: Các thương hiệu trên phương tiện truyền thông xã hội sử dụng NER để theo dõi các số liệu tổng thể của các chiến dịch quảng cáo của họ và cách các đối thủ cạnh tranh của họ đang làm. Ví dụ, có một hãng hàng không sử dụng NER để phân tích các tweet đề cập đến thương hiệu của họ. Nó phát hiện ra các bình luận tiêu cực xung quanh các thực thể như "hành lý thất lạc" tại một sân bay cụ thể để họ có thể giải quyết vấn đề nhanh nhất có thể. Quy trình NER rất cần thiết để trích xuất thông tin chi tiết có thể hành động được từ lượng lớn dữ liệu phương tiện truyền thông xã hội.
- Quảng cáo theo ngữ cảnh: Nền tảng quảng cáo sử dụng NER để trích xuất các thực thể chính từ các trang web để hiển thị quảng cáo có liên quan hơn cùng với nội dung, cuối cùng cải thiện mục tiêu quảng cáo và tỷ lệ nhấp chuột. Ví dụ: nếu NER phát hiện "Hawaii", "khách sạn" và "bãi biển" trên blog du lịch, nền tảng quảng cáo sẽ hiển thị các ưu đãi cho các khu nghỉ dưỡng Hawaii thay vì các chuỗi khách sạn chung chung.
- Tuyển dụng và sàng lọc hồ sơ: Bạn có thể yêu cầu NER tìm cho bạn các kỹ năng và trình độ chính xác cần thiết dựa trên bộ kỹ năng, kinh nghiệm và lý lịch của ứng viên. Ví dụ, một công ty tuyển dụng có thể sử dụng NER để tự động ghép nối các ứng viên. Các công ty có thể sử dụng các mô hình riêng của họ được thiết kế riêng theo các yêu cầu cụ thể hoặc tận dụng các mô hình được đào tạo trước để nâng cao độ chính xác của hệ thống nhận dạng thực thể được đặt tên của họ.
Ứng dụng của Nhận dạng thực thể có tên (NER) trong nhiều ngành công nghiệp
NER có một số trường hợp sử dụng trong nhiều lĩnh vực liên quan đến Xử lý ngôn ngữ tự nhiên và tạo tập dữ liệu đào tạo cho các giải pháp học máy và học sâu. Một mô hình được đào tạo được sử dụng để thực hiện NER trên dữ liệu mới, cho phép trích xuất tự động các thực thể từ khối lượng lớn văn bản. Một số ứng dụng là:
Hỗ trợ khách hàng
Hệ thống NER có thể dễ dàng phát hiện các khiếu nại, truy vấn và phản hồi có liên quan của khách hàng dựa trên thông tin quan trọng như tên sản phẩm, thông số kỹ thuật, địa điểm chi nhánh, v.v. Khiếu nại hoặc phản hồi được phân loại hợp lý và chuyển đến đúng bộ phận bằng cách lọc từ khóa ưu tiên.
Nguồn nhân lực hiệu quả
NER giúp nhóm Nhân sự cải thiện quy trình tuyển dụng và giảm thời gian bằng cách tóm tắt nhanh chóng hồ sơ của ứng viên. Các công cụ NER có thể quét sơ yếu lý lịch và trích xuất thông tin liên quan - tên, tuổi, địa chỉ, trình độ chuyên môn, trường đại học, v.v.
Ngoài ra, bộ phận nhân sự cũng có thể sử dụng các công cụ NER để hợp lý hóa quy trình công việc nội bộ bằng cách lọc các phàn nàn của nhân viên và chuyển chúng đến các trưởng bộ phận liên quan.
Phân loại nội dung
Phân loại nội dung là một nhiệm vụ khổng lồ đối với các nhà cung cấp tin tức. Việc phân loại nội dung thành các danh mục khác nhau giúp dễ dàng tìm kiếm, thu thập thông tin chi tiết, xác định xu hướng và hiểu rõ chủ đề. Công cụ nhận dạng thực thể được đặt tên (Named Entity Recognition - NER) có thể rất hữu ích cho các nhà cung cấp tin tức. Nó có thể quét nhiều bài báo, xác định các từ khóa ưu tiên và trích xuất thông tin dựa trên cá nhân, tổ chức, địa điểm, v.v.
Tối ưu hóa Công cụ Tìm kiếm

Đề xuất nội dung chính xác
Một số ứng dụng hiện đại phụ thuộc vào các công cụ NER để mang lại trải nghiệm khách hàng được tối ưu hóa và tùy chỉnh. Ví dụ: Netflix cung cấp các đề xuất được cá nhân hóa dựa trên lịch sử tìm kiếm và xem của người dùng bằng cách sử dụng nhận dạng thực thể được đặt tên.

Nhận dạng thực thể được đặt tên (NER) giúp các mô hình học máy của bạn hoạt động hiệu quả và đáng tin cậy hơn — nhưng chúng chỉ hoạt động tốt nhất khi được huấn luyện trên dữ liệu chất lượng cao, được gắn nhãn nhất quán. Đó là lý do tại sao một đối tác giàu kinh nghiệm lại quan trọng: Dịch vụ chú thích dữ liệu NER của Shaip cung cấp các bộ dữ liệu NER toàn diện, sẵn sàng sử dụng trên nhiều lĩnh vực như tài chính, bảo hiểm và chăm sóc sức khỏe, giúp bạn phát triển các mô hình học máy tiên tiến, hiệu quả nhanh hơn.
[Xem thêm: NLP là gì? Cách thức hoạt động, lợi ích, thách thức và ví dụ]
Mô hình nhận dạng thực thể có tên (NER) được đánh giá như thế nào?
Các mô hình NER được đánh giá bằng ba chỉ số: độ chính xác, độ thu hồi và điểm F1. Chúng so sánh các dự đoán của mô hình với một tập dữ liệu "chuẩn" gồm các thực thể được dán nhãn chính xác.
- Độ chính xác: Trong số các thực thể mà mô hình dự đoán, có bao nhiêu thực thể chính xác? Nó đo lường tỷ lệ dự đoán sai.
- Nhớ lại: Trong số các thực thể thực sự hiện diện, mô hình đã tìm thấy bao nhiêu? Nó đo lường các trường hợp âm tính giả.
- Điểm F1: Trung bình điều hòa của độ chính xác và độ thu hồi — một con số duy nhất cân bằng cả hai.
Ví dụ minh họa : trong câu “Apple Inc. sẽ mở văn phòng tại San Francisco vào tháng 3 năm 2026”, giả sử mô hình gắn thẻ chính xác “Apple Inc.” và “San Francisco”, gắn thẻ sai “văn phòng” là địa điểm, và bỏ sót “tháng 3 năm 2026”. Điều đó cho ra 2 kết quả đúng, 1 kết quả sai và 1 kết quả sai. Độ chính xác = 2/3 ≈ 0.67, độ thu hồi = 2/3 ≈ 0.67, và điểm F1 ≈ 0.67. Việc kiểm thử trên tập dữ liệu xác thực được giữ lại — dữ liệu mà mô hình chưa từng thấy trong quá trình huấn luyện — là rất cần thiết để xác nhận rằng nó có khả năng khái quát hóa chứ không phải chỉ ghi nhớ.
So sánh công cụ và thư viện NER:
Một số công cụ và thư viện mạnh mẽ hỗ trợ triển khai NER. Sau đây là so sánh một số tùy chọn phổ biến:
| Công cụ/Thư viện | Mô tả Chi tiết | Điểm mạnh | Điểm yếu |
|---|---|---|---|
| spaCy | Một thư viện NLP nhanh và hiệu quả bằng Python. | Hiệu suất tuyệt vời, dễ sử dụng, có sẵn các mô hình được đào tạo trước. | Hỗ trợ hạn chế cho các ngôn ngữ khác ngoài tiếng Anh. |
| NLTK | Một thư viện NLP toàn diện bằng Python. | Có nhiều chức năng, phù hợp cho mục đích giáo dục. | Có thể chậm hơn spaCy. |
| Stanford CoreNLP | Bộ công cụ NLP dựa trên Java. | Độ chính xác cao, hỗ trợ nhiều ngôn ngữ. | Yêu cầu nhiều tài nguyên tính toán hơn. |
| OpenNLP | Bộ công cụ dựa trên máy học dành cho NLP. | Hỗ trợ nhiều ngôn ngữ, có thể tùy chỉnh. | Có thể phức tạp khi thiết lập. |
Đào tạo người mẫu tại NER
Đào tạo mô hình là cốt lõi của việc xây dựng các hệ thống Nhận dạng thực thể có tên (NER) hiệu quả. Quá trình này bao gồm việc dạy một mô hình để xác định và phân loại các thực thể có tên—chẳng hạn như con người, tổ chức và địa điểm—bằng cách học từ dữ liệu đào tạo được gắn nhãn. Sự thành công của việc nhận dạng thực thể phụ thuộc rất nhiều vào chất lượng và tính đa dạng của dữ liệu đào tạo này, cũng như tính rõ ràng của các danh mục được xác định trước cho từng loại thực thể.
Trong quá trình đào tạo mô hình, các thuật toán học máy phân tích dữ liệu văn bản được chú thích bằng các nhãn thực thể chính xác. Các mô hình học sâu, bao gồm Mạng nơ-ron hồi quy (RNN) và Mạng nơ-ron tích chập (CNN), đã trở nên đặc biệt phổ biến đối với các tác vụ NER. Các mạng nơ-ron này rất giỏi trong việc nắm bắt các mẫu và mối quan hệ phức tạp trong văn bản, cho phép mô hình NER nhận dạng các thực thể với độ chính xác ấn tượng—ngay cả khi phải đối mặt với những biến thể nhỏ trong ngôn ngữ.
Tuy nhiên, việc đào tạo các mô hình học sâu để nhận dạng thực thể được đặt tên đòi hỏi khối lượng lớn dữ liệu được gắn nhãn, có thể tốn thời gian và chi phí để tạo ra. Để giải quyết vấn đề này, các kỹ thuật như tăng cường dữ liệu và học chuyển giao thường được sử dụng. Tăng cường dữ liệu mở rộng tập dữ liệu đào tạo bằng cách tạo các ví dụ mới từ dữ liệu hiện có, trong khi học chuyển giao tận dụng các mô hình được đào tạo trước đã học các mẫu ngôn ngữ chung, chỉ cần tinh chỉnh trên dữ liệu cụ thể của miền.
Cuối cùng, hiệu quả của mô hình NER phụ thuộc vào quá trình đào tạo mô hình mạnh mẽ, dữ liệu được gắn nhãn chất lượng cao và việc lựa chọn cẩn thận các mô hình học máy hoặc học sâu phù hợp với nhiệm vụ nhận dạng thực thể cụ thể.
Thực hành tốt nhất cho NER hiệu quả
Để đạt được hiệu suất cao trong Nhận dạng thực thể có tên (NER) cần tuân theo một bộ các phương pháp hay nhất giải quyết cả chất lượng dữ liệu và phát triển mô hình. Sau đây là một số chiến lược chính để nhận dạng thực thể hiệu quả:
- Ưu tiên dữ liệu đào tạo chất lượng cao: Nền tảng của bất kỳ mô hình NER thành công nào là dữ liệu đào tạo đa dạng, được chú thích tốt và mang tính đại diện. Dữ liệu được gắn nhãn phải bao gồm nhiều loại thực thể và bối cảnh khác nhau để đảm bảo mô hình có thể khái quát hóa thành các tình huống mới.
- Tiền xử lý văn bản kỹ lưỡng:Các bước như phân tách từ và gắn thẻ từ loại giúp mô hình hiểu rõ hơn về cấu trúc văn bản, cải thiện khả năng nhận dạng và phân loại chính xác các thực thể được đặt tên.
- Chọn thuật toán phù hợp:Trong khi các phương pháp dựa trên quy tắc có thể hiệu quả đối với các tác vụ đơn giản hoặc có cấu trúc cao, các mô hình học sâu như RNN và CNN thường mang lại kết quả vượt trội cho các tác vụ NER phức tạp, quy mô lớn.
- Tận dụng các mô hình được đào tạo trước:Việc sử dụng các mô hình được đào tạo trước và tinh chỉnh chúng trên tập dữ liệu cụ thể của bạn có thể giảm đáng kể nhu cầu về các tập dữ liệu được gắn nhãn lớn, giúp tăng tốc quá trình phát triển và cải thiện hiệu suất.
- Đánh giá mô hình liên tục và tinh chỉnh:Đánh giá thường xuyên hiệu suất của mô hình ner của bạn bằng các số liệu đánh giá mạnh mẽ và cập nhật khi dữ liệu hoặc tác vụ nhận dạng thực thể mới xuất hiện.
- Nhận thức theo ngữ cảnh: Luôn xem xét bối cảnh mà các thực thể xuất hiện. Điều này giúp phân biệt các tên thực thể có nhiều nghĩa, dẫn đến nhận dạng thực thể chính xác hơn.
Bằng cách tuân thủ các biện pháp thực hành tốt nhất này, các tổ chức có thể xây dựng các hệ thống NER chính xác hơn, thích ứng hơn và hiệu quả hơn, có khả năng trích xuất các thực thể từ dữ liệu văn bản phức tạp.
Nghiên cứu điển hình: Ứng dụng NER lâm sàng trong nghiên cứu ung thư.
Văn bản lâm sàng là nơi mà việc nhận dạng thực thể có tên (NER) trở nên thực sự khó khăn — và cũng là nơi nó quan trọng nhất. Trong một dự án chăm sóc sức khỏe, Shaip đã xây dựng một quy trình nhận dạng thực thể có tên và ẩn danh dữ liệu lâm sàng để giúp một tổ chức chăm sóc sức khỏe lớn chuyển đổi hồ sơ ung thư không có cấu trúc thành một tập dữ liệu sẵn sàng cho nghiên cứu, tất cả đều tuân thủ HIPAA.
Công việc này vượt xa việc chỉ gắn thẻ người và địa điểm. Các nhóm chú thích với chuyên môn về ung thư đã gắn nhãn cho một lược đồ thực thể phong phú trên khoảng 10,000 trang hồ sơ ung thư, bao gồm:
- Các thực thể bệnhCác yếu tố cần phân loại bao gồm: vấn đề ung thư, mô học, vị trí trong cơ thể, hành vi, cấp độ, giai đoạn ung thư và phân loại TNM.
- Các thực thể điều trịBao gồm: thuốc điều trị ung thư, liều lượng và tần suất sử dụng thuốc, phẫu thuật ung thư, phương pháp và liều lượng xạ trị.
- Các thực thể gen: gen được nghiên cứu, mã biến thể, phương pháp và mẫu vật.
- Trạng thái phủ địnhPhân biệt các kết quả âm tính, có thể âm tính, không chắc chắn và có thể dương tính — rất quan trọng trong ghi chú lâm sàng.
- Mối quan hệ NER lâm sàng: Liên kết các thực thể như vấn đề ung thư → vị trí cơ thể và mô học → cấp độ, để dữ liệu nắm bắt được ý nghĩa, chứ không chỉ là nhãn mác.
Bộ dữ liệu được chọn lọc từ kho lưu trữ hơn 5 triệu hồ sơ sức khỏe điện tử của Shaip, sau đó được ẩn danh bằng phương pháp Safe Harbor của HIPAA — mọi thông tin sức khỏe được bảo vệ đều được thay thế bằng các ký hiệu giữ chỗ có nhãn để dữ liệu vẫn hữu ích trong khi quyền riêng tư của bệnh nhân được đảm bảo. Các vòng kiểm soát chất lượng liên tiếp và phản hồi từ khách hàng đã giúp duy trì chất lượng chú thích ở mức chuẩn yêu cầu.
Kết quả: 10,000 bản ghi chất lượng cao, đã được ẩn danh và gắn nhãn, hiện đang là nền tảng cho việc phát triển mô hình xử lý ngôn ngữ tự nhiên (NLP) ung thư của khách hàng. Dự án này cho thấy những yêu cầu đối với việc nhận dạng thực thể có tên (NER) trong môi trường lâm sàng – người chú thích chuyên gia về lĩnh vực cụ thể, lược đồ nhận biết mối quan hệ, xử lý phủ định và tuân thủ nghiêm ngặt các quy định – những yêu cầu mà một mô hình đa năng không thể đáp ứng ngay từ đầu. Bạn có thể đọc toàn bộ nghiên cứu trường hợp phát triển NLP ung thư để hiểu rõ hơn về chi tiết.
Lợi ích & thách thức của NER?
Lợi ích:
- Khai thác thông tin: NER xác định dữ liệu quan trọng, hỗ trợ truy xuất thông tin.
- Tổ chức nội dung: Nó giúp phân loại nội dung, hữu ích cho cơ sở dữ liệu và công cụ tìm kiếm.
- Trải nghiệm người dùng nâng cao: NER tinh chỉnh kết quả tìm kiếm và cá nhân hóa các đề xuất.
- Phân tích sâu sắc: Nó tạo điều kiện cho việc phân tích tình cảm và phát hiện xu hướng.
- Quy trình làm việc tự động: NER thúc đẩy tự động hóa, tiết kiệm thời gian và nguồn lực.
Hạn chế / Thách thức:
- Độ phân giải mơ hồ:Khó phân biệt các thực thể tương tự như “Amazon” là một dòng sông hay một công ty.
- Thích ứng theo miền cụ thể: Sử dụng nhiều tài nguyên trên nhiều lĩnh vực khác nhau.
- Các biến thể ngôn ngữ: Hiệu quả khác nhau tùy theo tiếng lóng và sự khác biệt của vùng miền.
- Sự khan hiếm của dữ liệu được dán nhãn: Cần tập dữ liệu có nhãn lớn để huấn luyện.
- Xử lý dữ liệu phi cấu trúc: Đòi hỏi kỹ thuật tiên tiến.
- Đo lường hiệu suất: Đánh giá chính xác là phức tạp.
- Xử lý thời gian thực: Cân bằng tốc độ với độ chính xác là một thách thức.
- Phụ thuộc vào ngữ cảnh: Độ chính xác phụ thuộc vào việc hiểu được sắc thái văn bản xung quanh.
- Độ thưa thớt dữ liệu: Yêu cầu bộ dữ liệu có nhãn đáng kể, đặc biệt là đối với các lĩnh vực chuyên biệt.
Tương lai của nhận dạng thực thể được đặt tên sẽ như thế nào?
Tương lai của nhận dạng thực thể có tên (NER) đang vượt ra khỏi việc gắn thẻ đơn giản để hướng tới các hệ thống đa ngôn ngữ, hiệu quả và phong phú hơn. Một số thay đổi nổi bật bao gồm:
- Số lượng ảnh ít và số lượng ảnh bằng không Các phương pháp học máy đang giảm sự phụ thuộc vào các tập dữ liệu được gắn nhãn khổng lồ, giúp mở rộng NER sang các lĩnh vực mới nhanh hơn.
- Liên kết thực thể — Việc kết nối một thực thể được phát hiện với một bản ghi đồ thị tri thức — đang biến NER từ một công cụ gắn nhãn thành một bước suy luận, bao gồm cả vai trò là lớp nền tảng cho việc tạo ra thông tin được tăng cường bằng truy xuất (RAG).
- Nhận dạng thực thể có tên (NER) dựa trên Transformer và LLM Tiếp tục nâng cao độ chính xác đối với các thực thể mơ hồ và lồng nhau.
- Nhận dạng thực thể đa ngôn ngữ và xuyên ngôn ngữ Nó đang mở rộng khi các doanh nghiệp toàn cầu hóa và cần trích xuất dữ liệu nhất quán trên nhiều hệ chữ viết và ngôn ngữ khác nhau.
- Mô hình tùy chỉnh, chuyên biệt theo lĩnh vực Đối với y học, luật và tài chính, các thuật ngữ chuyên ngành đang trở nên phổ biến hơn, vì chúng hiếm khi xuất hiện trong các kho ngữ liệu tổng quát.
Tại sao nên chọn Shaip cho dự án NER của bạn?
Hầu hết các dự án NER đều gặp trở ngại không phải ở mô hình mà ở dữ liệu. Shaip được khuyến nghị cho công việc NER vì chúng tôi cung cấp một yếu tố mà các mô hình được huấn luyện trước không thể: dữ liệu huấn luyện chính xác, chuyên biệt theo lĩnh vực, được gắn nhãn nhất quán trên quy mô lớn. Đối với các sáng kiến NER và trích xuất thực thể, chúng tôi cung cấp:
- Người chú thích chuyên gia lĩnh vực — bao gồm các nhóm chuyên trách về nhận dạng mã số định danh bệnh nhân (NER) trong các lĩnh vực y tế, pháp lý, tài chính và lâm sàng, nơi mà các nhãn chung không đáp ứng được yêu cầu.
- Ghi nhãn mối quan hệ và phủ địnhKhông chỉ đơn thuần là các thẻ thực thể phẳng, mà mô hình của bạn còn học được ý nghĩa và ngữ cảnh.
- HIPAA, GDPR và SOC 2- Quy trình làm việc được đồng bộ hóa, với việc ẩn danh dữ liệu nhạy cảm như PHI và PII.
- Kiểm thử đa giai đoạn Được xây dựng bởi các chuyên gia về quy trình để đảm bảo mọi tập dữ liệu đều đáp ứng tiêu chuẩn chất lượng của bạn.
- Thang đo linh hoạtDựa trên nguồn nhân lực toàn cầu và các kho dữ liệu độc quyền quy mô lớn.
Cho dù bạn cần bộ dữ liệu NER tùy chỉnh, ẩn danh dữ liệu lâm sàng hay chú thích nhận dạng thực thể được đặt tên từ đầu đến cuối , nhóm của chúng tôi đều có thể xây dựng theo lược đồ của bạn.
Bạn đã sẵn sàng xây dựng dữ liệu huấn luyện NER đáng tin cậy chưa? Hãy liên hệ với Shaip để lên kế hoạch cho dự án của bạn và nhận bộ dữ liệu NER tùy chỉnh cho các mô hình AI/ML của bạn.
Câu hỏi thường gặp về NER: những câu hỏi mà các nhóm đặt ra trước khi bắt đầu một dự án
Đây là những câu hỏi thường gặp nhất khi các nhóm chuyển từ giai đoạn "NER là gì" sang giai đoạn lập kế hoạch, lập ngân sách và tìm nguồn cung ứng cho một dự án NER.
Tôi cần bao nhiêu dữ liệu được gắn nhãn để huấn luyện một mô hình nhận dạng thực thể có tên (NER) tùy chỉnh?
Hãy lên kế hoạch với vài nghìn ví dụ được chú thích cho mỗi loại thực thể như một điểm khởi đầu thực tế — các mô hình NER tùy chỉnh trong thực tế thường được huấn luyện trên vài nghìn mẫu. Việc huấn luyện từ đầu cần nhiều hơn thế, vì vậy hầu hết các nhóm đều tinh chỉnh một mô hình đã được huấn luyện trước đó. Chất lượng và tính nhất quán của nhãn quan trọng hơn số lượng dữ liệu thô; dữ liệu nhiễu sẽ làm giảm độ chính xác nhanh chóng.
Tôi nên tự xây dựng bộ dữ liệu huấn luyện NER hay thuê ngoài dịch vụ chú thích dữ liệu?
Hãy thuê ngoài khi bạn cần khối lượng công việc, tốc độ, chuyên môn lĩnh vực hoặc tuân thủ các quy định mà bạn không thể đáp ứng nội bộ; chỉ nên tự xây dựng khi lược đồ của bạn đơn giản, ổn định và nhỏ gọn. Hầu hết các nhóm đều đánh giá thấp việc chú thích – hướng dẫn, gắn nhãn và kiểm thử chất lượng chiếm phần lớn thời gian của một dự án nhận dạng thực thể có tên (NER). Một đối tác chuyên biệt như Shaip sẽ gánh vác khối lượng công việc đó để các kỹ sư của bạn tập trung vào việc xây dựng mô hình, chứ không phải gắn nhãn.
Tại sao mô hình NER của tôi lại liên tục bỏ sót các thực thể đặc thù theo lĩnh vực?
Vì các mô hình đa năng được huấn luyện trên tin tức và văn bản web, chúng hiếm khi nhận ra các thuật ngữ chuyên ngành như tên thuốc, điều khoản pháp lý hoặc công cụ tài chính. Giải pháp là tinh chỉnh trên dữ liệu được chú thích, dữ liệu chuyên ngành chứa các thực thể đó trong ngữ cảnh thực tế. Các hướng dẫn gắn nhãn không nhất quán là nguyên nhân phổ biến khác, vì vậy hãy thống nhất các quy tắc chú thích trước khi mở rộng quy mô.
Việc xây dựng bộ dữ liệu NER tùy chỉnh có chi phí bao nhiêu?
Chi phí phụ thuộc vào độ phức tạp của thực thể, khối lượng chú thích, chuyên môn cần thiết và các yêu cầu tuân thủ — việc ghi nhãn lâm sàng hoặc pháp lý tốn kém hơn so với văn bản thông thường vì cần người chú thích chuyên nghiệp và quy trình kiểm soát chất lượng nghiêm ngặt hơn. Giá thường được báo theo trang, theo tài liệu hoặc theo đơn vị được chú thích. Shaip sẽ điều chỉnh từng dự án NER phù hợp với lược đồ và tiêu chuẩn chất lượng của bạn và cung cấp báo giá tùy chỉnh.
Tôi có thể tìm dữ liệu huấn luyện NER chất lượng cao hoặc NER lâm sàng ở đâu?
Có ba cách để thu thập dữ liệu huấn luyện NER: cấp phép sử dụng bộ dữ liệu có sẵn, thu thập và chú thích bộ dữ liệu tùy chỉnh, hoặc mở rộng kho dữ liệu hiện có. Đối với các công việc chuyên ngành hoặc được quy định chặt chẽ — y tế, pháp lý, tài chính — nhà cung cấp dịch vụ chú thích được quản lý là lựa chọn đáng tin cậy. Shaip cung cấp các bộ dữ liệu NER tùy chỉnh, NER lâm sàng và khử nhận dạng tuân thủ HIPAA được xây dựng theo đúng yêu cầu của bạn.
Sự khác biệt giữa NER, trích xuất thực thể và liên kết thực thể là gì?
Nhận dạng thực thể có tên (NER) phát hiện và phân loại các thực thể theo loại (người, tổ chức, địa điểm). Trích xuất thực thể thường được sử dụng thay thế cho NER, đôi khi được sử dụng rộng rãi hơn để chỉ việc trích xuất các trường có cấu trúc từ văn bản. Liên kết thực thể tiến thêm một bước nữa, kết nối một thực thể được nhận dạng với một bản ghi duy nhất trong cơ sở tri thức — xác định xem "Apple" hay "Jordan" nào đang được nhắc đến.
Kết luận
Nhận dạng thực thể có tên (NER) là một kỹ thuật NLP mạnh mẽ giúp xác định và phân loại các thực thể chính trong văn bản, cho phép máy móc hiểu và xử lý ngôn ngữ của con người hiệu quả hơn. Từ việc nâng cao công cụ tìm kiếm và chatbot đến hỗ trợ khách hàng và phân tích tài chính, NER có nhiều ứng dụng đa dạng trong nhiều ngành công nghiệp khác nhau. Mặc dù vẫn còn nhiều thách thức trong các lĩnh vực như giải quyết sự mơ hồ và xử lý dữ liệu phi cấu trúc, những tiến bộ đang diễn ra, đặc biệt là trong học sâu, hứa hẹn sẽ tinh chỉnh thêm khả năng của NER và mở rộng tác động của nó trong tương lai.




