
-
-
-
Đào tạo & Tinh chỉnh
-
Đánh giá chuyên gia được quản lý
-
-
Đặc biệt
-
-
Tên Công Ty
Từ lâu, người ta đã bàn luận về việc Trí tuệ Nhân tạo (AI) sẽ thay đổi mọi khía cạnh của cuộc sống con người như thế nào, và đến nay chắc hẳn bạn đã nhận ra rằng nó có tiềm năng trở thành công nghệ mang tính đột phá nhất từ trước đến nay. Ngày nay, chúng ta có thể trò chuyện với Siri, Cortana hay Google để được giải đáp những thắc mắc cơ bản, nhưng phần lớn tiềm năng thực sự của chúng vẫn chưa được biết đến.
Xây dựng trí tuệ nhân tạo (AI) có khả năng thực sự hiểu ngôn ngữ con người đòi hỏi nhiều hơn dữ liệu thô — nó cần các bộ dữ liệu huấn luyện được gắn nhãn chính xác, do các chuyên gia ngôn ngữ thực hiện và cung cấp ở quy mô doanh nghiệp. Shaip là nhà cung cấp dịch vụ xử lý ngôn ngữ tự nhiên (NLP) hàng đầu, cung cấp các dịch vụ và giải pháp xử lý ngôn ngữ tự nhiên toàn diện cho các nhóm AI trên toàn thế giới: từ thu thập dữ liệu văn bản và âm thanh tùy chỉnh đến chú thích chuyên gia, các bộ dữ liệu NLP có sẵn và quản lý toàn diện nguồn nhân lực trên hơn 150 ngôn ngữ.
Cho dù bạn đang huấn luyện hệ thống AI đàm thoại, tinh chỉnh mô hình ngôn ngữ lớn (LLM), xây dựng công cụ phân tích cảm xúc hay mở rộng quy mô hệ thống nhận dạng thực thể được đặt tên (NER) — hơn 30 cộng tác viên được chứng nhận của Shaip cung cấp dữ liệu huấn luyện NLP có cấu trúc, chất lượng cao mà các mô hình của bạn cần để hoạt động chính xác trong thế giới thực. Được các công ty thuộc Fortune 500 trong lĩnh vực chăm sóc sức khỏe, tài chính, công nghệ và bán lẻ tin dùng, các giải pháp NLP của Shaip kết hợp các công cụ nền tảng độc quyền, quy trình chất lượng 6 Sigma và các chuyên gia trong lĩnh vực để đáp ứng các yêu cầu về độ chính xác và thông lượng của AI cấp độ sản xuất.

Mọi mô hình ngôn ngữ hiệu suất cao đều bắt đầu bằng dữ liệu huấn luyện được xây dựng chuyên biệt, dành riêng cho từng lĩnh vực. Dịch vụ thu thập dữ liệu NLP của Shaip cung cấp chính xác dữ liệu đầu vào mà mô hình của bạn cần — với số lượng lớn, bằng ngôn ngữ của bạn và với sự đa dạng ngôn ngữ mà việc triển khai thực tế đòi hỏi.
Chúng tôi thu thập các kho dữ liệu văn bản lớn, được tùy chỉnh theo nhiều định dạng khác nhau: email, đánh giá của khách hàng, bài đăng trên mạng xã hội, phiếu hỗ trợ, hợp đồng pháp lý, tài liệu tài chính, và hơn thế nữa. Có sẵn hơn 150 ngôn ngữ và phương ngữ khu vực, dịch vụ thu thập văn bản của chúng tôi hỗ trợ đào tạo chatbot, tinh chỉnh LLM, hệ thống tìm kiếm liên quan và quy trình hiểu tài liệu.
Từ các lời nhắc được lập trình sẵn đến các đoạn hội thoại tự phát, Shaip thu thập các bản ghi âm chất lượng cao được tùy chỉnh theo yêu cầu về nhận dạng giọng nói tự động (ASR) hoặc trí tuệ nhân tạo giọng nói (AI) của bạn — bao gồm các giọng điệu cụ thể, môi trường nhiễu, thông tin nhân khẩu học của người nói và điều kiện kênh truyền. Được cung cấp dưới dạng các bộ sưu tập độc lập hoặc các gói ASR hoàn chỉnh với bản ghi chép, từ điển phát âm và tài liệu dành riêng cho từng ngôn ngữ để huấn luyện mô hình ngay lập tức. Tất cả dữ liệu được thu thập đều được cung cấp đầy đủ siêu dữ liệu, thông tin người nói và xác minh chất lượng thông qua nền tảng chú thích độc quyền của Shaip.
Các mô hình xử lý ngôn ngữ tự nhiên (NLP) chính xác đòi hỏi dữ liệu huấn luyện được chú thích chính xác. Dịch vụ chú thích dữ liệu của Shaip kết hợp đội ngũ nhân lực đa ngôn ngữ có chứng chỉ với nền tảng độc quyền để cung cấp các nhãn chính xác nhất quán ở quy mô doanh nghiệp — với các cổng kiểm soát chất lượng tích hợp và theo dõi quá trình giao hàng minh bạch.

Khả năng chú thích NLP của chúng tôi bao gồm mọi loại nhiệm vụ chính:
Tất cả các chú thích đều được thực hiện thông qua quy trình kiểm soát chất lượng theo từng giai đoạn 6 Sigma với việc chấm điểm sự nhất trí giữa các người chú thích và các vòng phản hồi liên tục.

Hãy duyệt qua bộ dữ liệu âm thanh đa dạng của chúng tôi, bao gồm hơn 20,000 giờ âm thanh từ các bộ dữ liệu xử lý ngôn ngữ tự nhiên (NLP) có sẵn, về nhiều chủ đề khác nhau như tổng đài, hội thoại thông thường, tranh luận, bài phát biểu, bài thuyết trình, phim tài liệu, sự kiện, phim ảnh, tin tức, v.v., bằng hơn 40 ngôn ngữ.
Chúng tôi cung cấp nguồn nhân lực lành nghề, trở thành một phần mở rộng của nhóm bạn để hỗ trợ các nhiệm vụ chú thích dữ liệu, thông qua các công cụ mà bạn ưa thích trong khi vẫn duy trì chất lượng mong muốn. Đội ngũ nhân viên giàu kinh nghiệm của chúng tôi hiểu rõ những sắc thái tinh tế trong ngôn ngữ con người và áp dụng các phương pháp tốt nhất được học hỏi từ việc gắn nhãn hàng triệu tài liệu âm thanh và văn bản để cung cấp giải pháp gắn nhãn dữ liệu đẳng cấp thế giới cho xử lý ngôn ngữ tự nhiên.

Từ việc thu thập văn bản/âm thanh đến chú thích, chúng tôi mang đến sự hiểu biết sâu sắc hơn về thế giới ngôn ngữ nói với văn bản và âm thanh được gắn nhãn chi tiết, chính xác để cải thiện hiệu suất của các mô hình xử lý ngôn ngữ tự nhiên (NLP) của bạn. Cho dù bạn đang đào tạo trợ lý ảo/kỹ thuật số, muốn xem xét hợp đồng pháp lý hay xây dựng thuật toán phân tích tài chính, chúng tôi đều cung cấp dữ liệu tiêu chuẩn vàng mà bạn cần để các mô hình của bạn hoạt động trong thế giới thực. Đội ngũ của chúng tôi hiểu rõ ngôn ngữ, phương ngữ, cú pháp và cấu trúc câu để gắn thẻ văn bản chính xác, dựa trên yêu cầu kinh doanh của bạn.
Chúng tôi là một trong số ít các công ty xử lý ngôn ngữ tự nhiên (NLP) tự hào về năng lực ngôn ngữ vượt trội của mình. Chúng tôi có đội ngũ nhân viên toàn cầu gồm hơn 30,000 cộng tác viên đến từ khắp nơi trên thế giới, với chuyên môn về hơn 150 ngôn ngữ . Chúng tôi đã hỗ trợ các công ty khởi nghiệp giai đoạn đầu, các doanh nghiệp vừa và nhỏ, và hợp tác với các công ty hàng đầu trong danh sách Fortune 500 thuộc nhiều lĩnh vực khác nhau như chăm sóc sức khỏe, bán lẻ/thương mại điện tử, tài chính, công nghệ, v.v. để đạt được mục tiêu dự án NLP của họ.
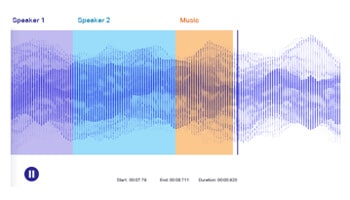
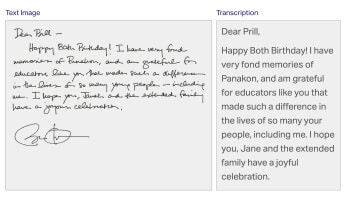
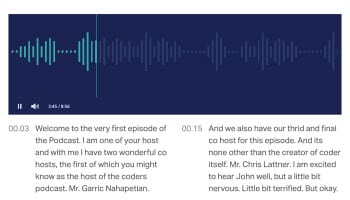
Hơn 50k giờ tập dữ liệu âm thanh / giọng nói có sẵn để giúp bạn tiếp tục.
Phân tích cảm xúc của con người bằng cách diễn giải các sắc thái trong đánh giá của khách hàng, phương tiện truyền thông xã hội, v.v.

Thu thập bộ dữ liệu văn bản, ví dụ, email, SMS, blog, tài liệu, bài nghiên cứu, v.v.

Đào tạo trợ lý kỹ thuật số yêu cầu một tập hợp lớn dữ liệu chất lượng từ các khu vực địa lý, ngôn ngữ, phương ngữ, thiết lập và định dạng khác nhau. Tại Shaip, chúng tôi cung cấp dữ liệu đào tạo cho các Mô hình AI với Nhân viên trực tiếp có kiến thức cần thiết, chuyên môn về lĩnh vực và nhận thức rõ về nhu cầu cụ thể của khách hàng.
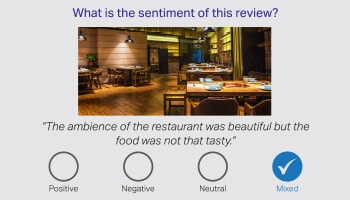
Người ta nói đúng rằng, một mình từ ngữ không truyền đạt được toàn bộ câu chuyện, và nguyên nhân nằm ở các nhà chú giải của con người để giải thích sự mơ hồ trong ngôn ngữ của con người. Do đó, việc xác định Cảm xúc của khách hàng, dựa trên cuộc trò chuyện là vô cùng quan trọng. Các chuyên gia ngôn ngữ của chúng tôi từ các lĩnh vực khác nhau có thể diễn giải các sắc thái trong các bài đánh giá sản phẩm, tin tức tài chính và phương tiện truyền thông xã hội.
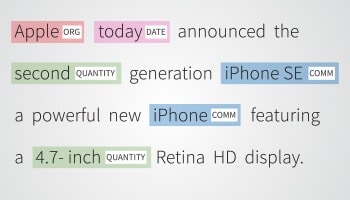
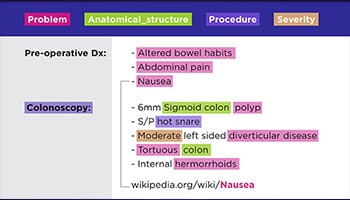
Nhận dạng đối tượng được đặt tên (NER) là xác định, trích xuất và phân loại các đối tượng được đặt tên trong văn bản, thành các danh mục được xác định trước. Văn bản có thể được phân loại thành địa điểm, tên, tổ chức, sản phẩm, số lượng, giá trị, tỷ lệ phần trăm, v.v. Với NER, bạn có thể giải quyết các câu hỏi trong thế giới thực như tổ chức nào đã được đề cập trong bài báo, v.v.
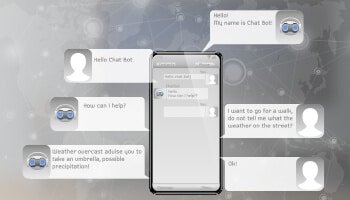
Các Chatbots ảo hoặc Trợ lý kỹ thuật số mạnh mẽ, được đào tạo bài bản đã tạo ra một cuộc cách mạng trong cách khách hàng giao tiếp với người bán, góp phần cải thiện đáng kể trải nghiệm của khách hàng.
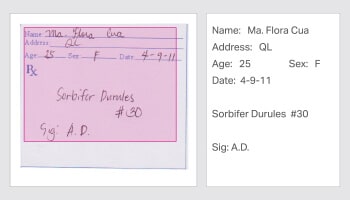
Từ đơn thuốc viết tay của bác sĩ đến ghi chú cuộc gọi hội nghị, các chuyên gia của chúng tôi có thể số hóa bất kỳ dạng dữ liệu nào, chẳng hạn như tài liệu lưu trữ, hợp đồng pháp lý, hồ sơ sức khỏe bệnh nhân, v.v.
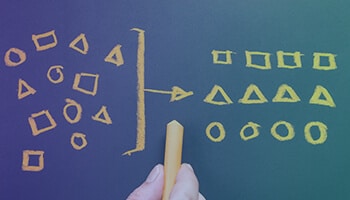
Phân loại còn được gọi là phân loại hoặc gắn thẻ là quá trình phân loại văn bản thành các nhóm có tổ chức và dán nhãn cho nó, dựa trên các tính năng quan tâm của nó.
Đánh giá thủ công và biên tập lại kết quả dịch máy để đo lường tính trôi chảy, độ phù hợp và độ chính xác về lĩnh vực — từ đó tạo điều kiện cho các hệ thống dịch máy đáng tin cậy được triển khai trên nhiều ngôn ngữ.
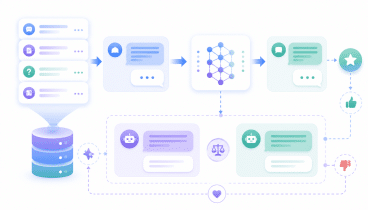
Các bộ dữ liệu về hành vi làm theo hướng dẫn, các cặp câu hỏi-phản hồi và dữ liệu về sở thích RLHF được chọn lọc để tinh chỉnh và điều chỉnh các mô hình ngôn ngữ lớn cho phù hợp với lĩnh vực, giọng điệu và yêu cầu nhiệm vụ của bạn.
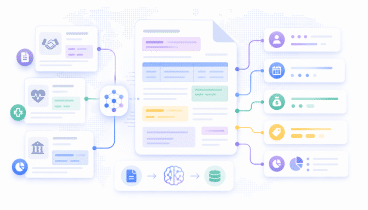
Chú thích các cấu trúc tài liệu phức tạp — hợp đồng, hồ sơ y tế, hồ sơ tài chính — để huấn luyện các mô hình AI tài liệu có khả năng trích xuất, phân loại và suy luận trên văn bản phi cấu trúc ở quy mô lớn.
Phân tích chủ đề hoặc gắn nhãn chủ đề là xác định và rút ra ý nghĩa từ một văn bản nhất định bằng cách xác định các chủ đề / chủ đề lặp lại đang được xem xét.
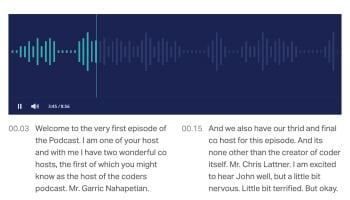
Chuyển lời nói / podcast / hội thảo, cuộc hội thoại thành văn bản. Tận dụng con người để chú thích chính xác các tệp âm thanh / giọng nói để đào tạo các mô hình NLP một cách chính xác.

Phân loại âm thanh hoặc lời nói để phân loại giọng nói / âm thanh dựa trên ngôn ngữ, phương ngữ, ngữ nghĩa, từ vựng, v.v.
Nhóm chuyên gia của chúng tôi, những người thành thạo về chú thích / ghi nhãn văn bản / âm thanh có thể mua các bộ dữ liệu NLP được chú thích chính xác và hiệu quả.
Nhóm của chúng tôi giúp bạn chuẩn bị dữ liệu văn bản / âm thanh để đào tạo động cơ AI, tiết kiệm thời gian và tài nguyên quý giá.
Đội ngũ cộng tác viên của chúng tôi có thể đáp ứng khối lượng bổ sung trong khi vẫn duy trì chất lượng dữ liệu đầu ra cho Giải pháp NLP của bạn.
Là chuyên gia trong việc đào tạo và quản lý các nhóm, chúng tôi đảm bảo các dự án được thực hiện trong phạm vi ngân sách xác định.
Nhóm phân tích dữ liệu từ nhiều nguồn và có khả năng tạo ra dữ liệu đào tạo AI một cách hiệu quả và với số lượng lớn trên tất cả các ngành.
Hàng loạt dữ liệu âm thanh / văn bản cung cấp cho AI lượng thông tin dồi dào cần thiết để đào tạo nhanh hơn.

Đội ngũ tận tâm và được đào tạo:

Đảm bảo hiệu quả quy trình cao nhất với:

Nền tảng được cấp bằng sáng chế cung cấp các lợi ích:
Trò chuyện AI cung cấp trải nghiệm người dùng nâng cao bằng cách học hỏi từ các tương tác trước đó, hiểu hành vi của người dùng và hiểu các ngôn ngữ khác nhau bằng cách sử dụng các kỹ năng ra quyết định nâng cao.

Nhận dạng giọng nói tự động (ASR) đã đi một chặng đường dài. Mặc dù nó đã được phát minh từ lâu, nhưng nó hầu như không được ai sử dụng. Tuy nhiên, thời gian và công nghệ hiện nay đã thay đổi đáng kể.

Thị trường xử lý ngôn ngữ tự nhiên toàn cầu dự kiến sẽ tăng từ 1.8 tỷ đô la vào năm 2021 lên 4.3 tỷ đô la vào năm 2026, tăng trưởng với tốc độ CAGR là 19.0% trong giai đoạn này.
Trao quyền cho các nhóm xây dựng các sản phẩm AI hàng đầu thế giới.


NLP là một nhánh của trí tuệ nhân tạo cho phép máy móc hiểu, phân tích và phản hồi ngôn ngữ của con người, cả văn bản và lời nói, bằng cách diễn giải ngữ cảnh, tình cảm và ý định.
NLP liên quan đến việc xử lý ngôn ngữ của con người bằng các thuật toán phân tích ngữ pháp, cú pháp, ngữ nghĩa và ngữ cảnh. Nó dựa vào khối lượng lớn dữ liệu được chú thích để đào tạo các mô hình AI nhằm trích xuất ý nghĩa, xác định các mẫu và tạo ra phản hồi chính xác.
NLP được sử dụng trong các ứng dụng như trợ lý ảo, chatbot, phân tích tình cảm, dịch máy, tóm tắt văn bản, phát hiện thư rác và sửa lỗi ngữ pháp. Nó cung cấp năng lượng cho các hệ thống giúp tương tác giữa người và máy tính hiệu quả và tự nhiên hơn.
Các dịch vụ NLP bao gồm thu thập văn bản (tìm nguồn dữ liệu văn bản đa dạng), thu thập âm thanh (ghi lại dữ liệu giọng nói), chú thích dữ liệu (gắn nhãn văn bản và âm thanh để đào tạo AI) và phiên âm (chuyển đổi giọng nói thành văn bản để phân tích).
Các giải pháp NLP cải thiện các mô hình AI bằng cách cung cấp các tập dữ liệu được gắn nhãn chính xác giúp các mô hình hiểu ngôn ngữ con người tốt hơn. Điều này cải thiện các tác vụ như phân tích tình cảm, nhận dạng thực thể được đặt tên (NER), AI đàm thoại và đào tạo chatbot.
Các ngành công nghiệp chính bao gồm chăm sóc sức khỏe (phân tích hồ sơ y tế và cảm nhận của bệnh nhân), tài chính (phát hiện gian lận và phân tích tài liệu) và thương mại điện tử (khuyến nghị được cá nhân hóa và tự động hóa hỗ trợ khách hàng).
Thời gian thay đổi tùy theo quy mô và độ phức tạp của dự án nhưng được tối ưu hóa để cung cấp dữ liệu chất lượng cao một cách hiệu quả.
Chất lượng được đảm bảo thông qua các quy trình xác thực nghiêm ngặt, chú thích viên chuyên gia và các công cụ tiên tiến, đảm bảo dữ liệu đáp ứng các tiêu chuẩn cao nhất.
Chi phí phụ thuộc vào các yếu tố như phạm vi dự án, độ phức tạp của dữ liệu và nhu cầu tùy chỉnh. Liên hệ với Shaip để nhận báo giá cá nhân dựa trên yêu cầu của bạn.
Dịch vụ xử lý ngôn ngữ tự nhiên (NLP) đề cập đến mô hình cung cấp dữ liệu được quản lý hoàn toàn, trong đó nhà cung cấp dịch vụ NLP xử lý mọi giai đoạn của quy trình xử lý dữ liệu ngôn ngữ của bạn — thu thập, chú thích, đảm bảo chất lượng và phân phối — thay mặt bạn. Shaip cung cấp các mô hình phân phối dựa trên dự án, theo gói đăng ký và theo nhóm tích hợp để phù hợp với các nhu cầu khác nhau của tổ chức và quy mô dự án.
Mỗi nhóm ngôn ngữ bao gồm những người bản ngữ hoặc gần bản ngữ được tuyển chọn và sàng lọc dựa trên kiến thức chuyên môn. Các chú thích được hiệu chỉnh dựa trên các bộ tham chiếu tiêu chuẩn vàng, và quy trình kiểm soát chất lượng 6 giai đoạn Sigma với việc chấm điểm sự nhất trí giữa các người chú thích đảm bảo tính nhất quán trên tất cả các cặp ngôn ngữ và phương ngữ.
Shaip vận hành các quy trình làm việc tuân thủ HIPAA cho các dự án xử lý ngôn ngữ tự nhiên (NLP) trong lĩnh vực chăm sóc sức khỏe và phù hợp với các yêu cầu quản lý sự đồng ý của GDPR đối với việc thu thập dữ liệu tại EU. Tất cả các dự án đều bao gồm tài liệu ghi chép nhật ký kiểm toán, hồ sơ nguồn gốc dữ liệu và kiểm soát truy cập dựa trên vai trò dành cho các nhóm tuân thủ quy định của doanh nghiệp.
Đúng vậy. Shaip cung cấp các bộ dữ liệu tuân theo hướng dẫn, các cặp phản hồi-lời nhắc và dữ liệu ưu tiên RLHF để tinh chỉnh và căn chỉnh LLM. Trang giải pháp Trí tuệ nhân tạo tạo sinh của chúng tôi bao gồm đầy đủ các dịch vụ dữ liệu huấn luyện LLM.
Thu thập dữ liệu bao gồm việc tìm nguồn văn bản hoặc âm thanh thô — nguyên liệu đầu vào mà mô hình của bạn sẽ sử dụng để học hỏi. Chú thích dữ liệu bao gồm việc gắn nhãn cho dữ liệu thô đó bằng các thẻ, danh mục, thực thể hoặc chỉ báo cảm xúc có cấu trúc để cho mô hình biết cần hiểu điều gì. Shaip cung cấp cả hai dịch vụ này dưới dạng dịch vụ độc lập hoặc giải pháp dữ liệu NLP tích hợp từ đầu đến cuối.
Vâng. Shaip đã từng làm việc với các công ty khởi nghiệp giai đoạn đầu, các doanh nghiệp vừa và nhỏ (SME) và các tập đoàn thuộc Fortune 500. Chúng tôi cung cấp phạm vi dự án linh hoạt, các gói bộ dữ liệu tối thiểu khả thi (MVP) cho AI giai đoạn MVP và các mô hình phân phối có thể mở rộng, phát triển cùng với nhu cầu chú thích dữ liệu của bạn. Liên hệ với chúng tôi để nhận báo giá tùy chỉnh.

Chúng tôi sử dụng cookie để cải thiện trải nghiệm của bạn trên trang web của chúng tôi. Bằng cách sử dụng trang web của chúng tôi, bạn đồng ý với cookie.
Quản lý tùy chọn cookie của bạn bên dưới:
Cookie thiết yếu cho phép các chức năng cơ bản và cần thiết cho chức năng phù hợp của trang web.
Trình quản lý thẻ Google giúp đơn giản hóa việc quản lý thẻ tiếp thị trên trang web của bạn mà không cần thay đổi mã.
Cookie thống kê thu thập thông tin ẩn danh. Thông tin này giúp chúng tôi hiểu cách khách truy cập sử dụng trang web của chúng tôi.
Google Analytics là một công cụ mạnh mẽ giúp theo dõi và phân tích lưu lượng truy cập trang web để đưa ra quyết định tiếp thị sáng suốt.
URL dịch vụ: policies.google.com (mở trong cửa sổ mới)
Cookie tiếp thị được sử dụng để theo dõi khách truy cập vào các trang web. Mục đích là hiển thị quảng cáo có liên quan và hấp dẫn với từng người dùng.
Google Ads là một nền tảng quảng cáo trực tuyến cho phép các doanh nghiệp tạo ra các quảng cáo nhắm mục tiêu, hiển thị trên kết quả tìm kiếm của Google và các trang web đối tác.
URL dịch vụ: policies.google.com (mở trong cửa sổ mới)
HubSpot là một nền tảng tích hợp toàn diện về tiếp thị, bán hàng và dịch vụ khách hàng, giúp tối ưu hóa sự phát triển của doanh nghiệp.
URL dịch vụ: legal.hubspot.com (mở trong cửa sổ mới)
Bạn có thể tìm thêm thông tin trong Chính sách Cookie và Chính sách Bảo mật của chúng tôi.