Nhận dạng giọng nói là công nghệ xác định và xác thực một người dựa trên các đặc điểm độc đáo của giọng nói của họ, trong khi công nghệ nhận dạng lời nói, có mối liên hệ mật thiết với nó, chuyển đổi lời nói thành văn bản hoặc lệnh. Cả hai cùng nhau tạo nên sức mạnh cho mọi thứ, từ loa thông minh và hệ thống điều khiển trên ô tô đến bảo mật ngân hàng và tài liệu lâm sàng. Thị trường nhận dạng giọng nói và lời nói toàn cầu được định giá 20.25 tỷ đô la vào năm 2023 và dự kiến sẽ đạt 53.67 tỷ đô la vào năm 2030, với tốc độ tăng trưởng kép hàng năm (CAGR) là 14.6% (Grand View Research, 2024) — và nhận dạng giọng nói là phân khúc chức năng phát triển nhanh nhất trong đó (Grand View Research, 2024).
Hướng dẫn này giải thích cách thức hoạt động của nhận dạng giọng nói, lĩnh vực ứng dụng, ưu điểm và hạn chế của nó, cũng như những thay đổi sẽ định hình lại lĩnh vực này vào năm 2026.
Các nội dung chính
- Nhận dạng giọng nói xác định người đang nói; nhận dạng lời nói hiểu nội dung được nói.
- Các hệ thống này phân tích cao độ, tần số, ngữ điệu và nhịp điệu để tạo ra một dấu ấn giọng nói độc đáo.
- Các ứng dụng hàng đầu: bảo mật và sinh trắc học, thiết bị điều khiển bằng giọng nói, dịch vụ khách hàng, chăm sóc sức khỏe và ô tô.
- Độ chính xác phụ thuộc rất nhiều vào dữ liệu huấn luyện đa dạng, được dán nhãn tốt trên nhiều giọng điệu và ngôn ngữ khác nhau. Việc thu thập dữ liệu đó ở quy mô lớn là lúc các giải pháp sẵn có phát huy tác dụng. bộ dữ liệu giọng nói Giúp các nhóm tiết kiệm hàng tháng trời thu thập dữ liệu.
- Các xu hướng năm 2026 bao gồm các mô hình AI chuyển đổi giọng nói thành giọng nói, xử lý trên thiết bị và phòng chống giả mạo giọng nói (deepfake).
Quy mô thị trường: Chỉ trong chưa đầy 20 năm, công nghệ nhận dạng giọng nói đã phát triển vượt bậc. Nhưng tương lai sẽ ra sao? Năm 2020, thị trường công nghệ nhận dạng giọng nói toàn cầu đạt khoảng 10.7 tỷ đô la. Dự kiến con số này sẽ tăng vọt lên 27.16 tỷ đô la vào năm 2026, với tốc độ tăng trưởng kép hàng năm (CAGR) là 16.8% từ năm 2021 đến năm 2026.
Công nghệ nhận dạng giọng nói là gì?
Lĩnh vực này bắt nguồn từ các hệ thống vào những năm 1950 chỉ có thể nhận dạng một vài chữ số. Các mô hình thống kê và sau đó là học sâu đã biến những thí nghiệm ban đầu đó thành các trợ lý luôn lắng nghe và các hệ thống xác thực giọng nói an toàn được hàng tỷ người sử dụng ngày nay.
Nhận dạng giọng nói – Ưu điểm và nhược điểm
Nhận dạng giọng nói hoạt động như thế nào?
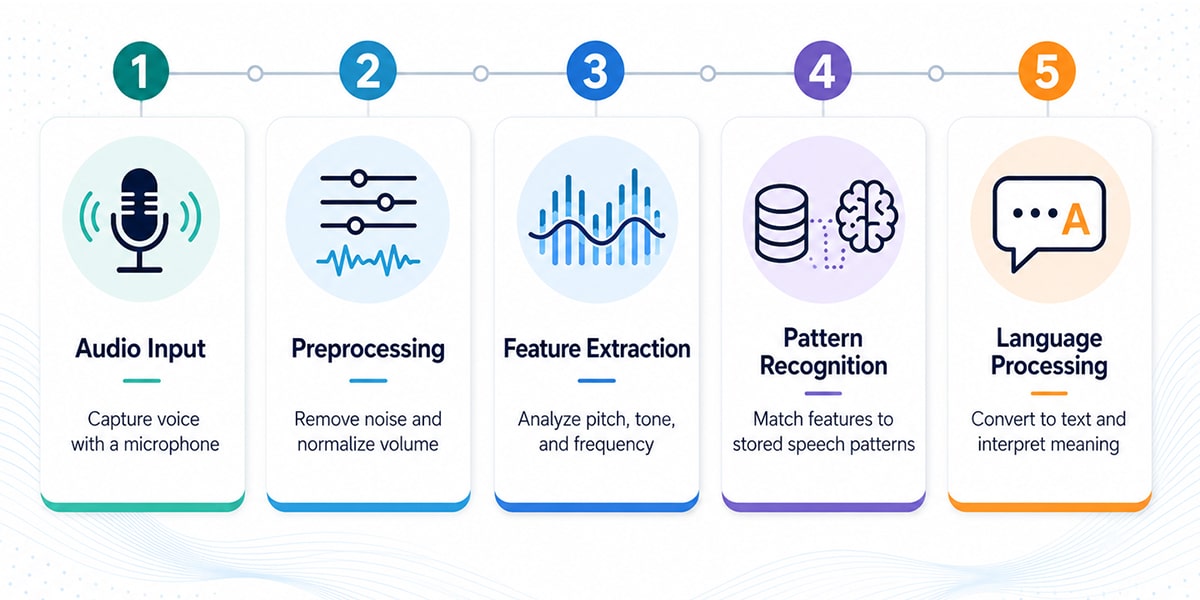
Đầu vào âm thanh : Quá trình bắt đầu bằng việc thu âm đầu vào bằng micro.
Xử lý sơ bộ : Tín hiệu âm thanh được làm sạch bằng cách loại bỏ nhiễu và chuẩn hóa âm lượng.
Trích xuất đặc trưng : Hệ thống phân tích âm thanh để trích xuất các đặc trưng chính như cao độ, âm sắc và tần số.
Nhận dạng mẫu : Các đặc trưng được trích xuất sẽ được so sánh với các mẫu giọng nói đã biết được lưu trữ trong cơ sở dữ liệu.
Xử lý ngôn ngữ : Các mẫu được nhận dạng sẽ được chuyển đổi thành văn bản, và các thuật toán xử lý ngôn ngữ tự nhiên (NLP) sẽ diễn giải ý nghĩa của chúng.
Các trường hợp sử dụng Nhận dạng giọng nói
Công nghệ nhận dạng giọng nói có nhiều ứng dụng trên nhiều lĩnh vực khác nhau. Dưới đây là một số trường hợp sử dụng chính:
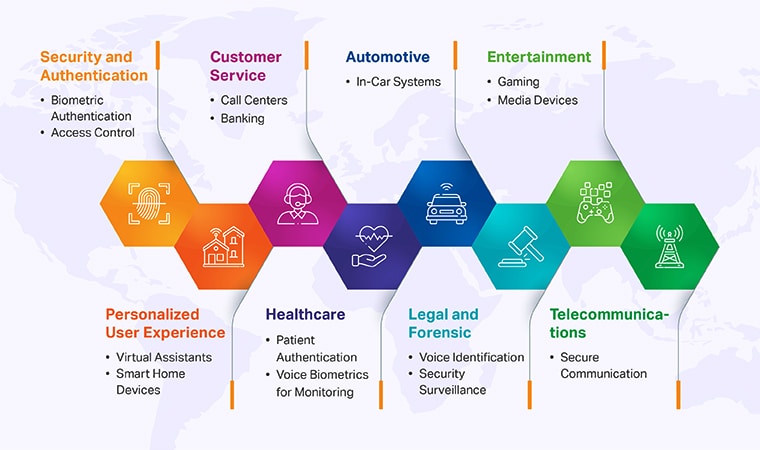
- Bảo mật và xác thực:
- Xác thực sinh trắc học: Được sử dụng trong điện thoại thông minh và các thiết bị khác để mở khóa màn hình và xác minh danh tính người dùng.
- Kiểm soát truy cập: Đảm bảo quyền truy cập vào các tòa nhà, khu vực an toàn và thông tin bí mật bằng cách nhận dạng nhân viên có thẩm quyền.
- Sản phẩm nhận dạng giọng nói:Ví dụ bao gồm các thiết bị nhà thông minh và hệ thống an ninh sử dụng nhận dạng giọng nói để điều khiển rảnh tay và tăng cường an ninh.
- Trải nghiệm người dùng được cá nhân hóa:
- Trợ lý ảo: Tùy chỉnh phản hồi và hành động dựa trên giọng nói của người dùng, mang lại sự tương tác được cá nhân hóa hơn.
- Thiết bị nhà thông minhNhận diện giọng nói của các thành viên trong gia đình để điều chỉnh cài đặt và tùy chọn cho từng cá nhân. Mỗi thiết bị rảnh tay này được kích hoạt bằng một từ đánh thức — và việc tạo ra một từ đánh thức chính xác, dành riêng cho thương hiệu sản phẩm của bạn đòi hỏi sự tùy chỉnh. đánh thức dữ liệu đào tạo từ.
- Nhập liệu bằng giọng nói: Được sử dụng như một công cụ năng suất để nhập dữ liệu và tự động hóa, cải thiện hiệu quả và độ chính xác trong nhiều môi trường khác nhau.
- Dịch Vụ CSKH:
- Trung tâm cuộc gọi: Nhận dạng khách hàng bằng giọng nói của họ, cho phép dịch vụ được cá nhân hóa và giảm nhu cầu xác minh danh tính lặp đi lặp lại.
- Ngân hàng: Xác minh khách hàng trong quá trình giao dịch ngân hàng qua điện thoại để có dịch vụ an toàn và hiệu quả.
- Phần mềm chuyển giọng nói thành văn bản: Chuyển đổi ngôn ngữ nói thành văn bản viết, cải thiện hiệu quả, dịch vụ khách hàng và độ chính xác trong giao tiếp.
- phù hợp túi tiền:
- Xác thực bệnh nhân: Xác nhận danh tính bệnh nhân trong các dịch vụ y tế từ xa và hồ sơ sức khỏe điện tử.
- Sinh trắc học giọng nói để giám sát: Theo dõi những bệnh nhân mắc các bệnh như trầm cảm bằng cách phân tích những thay đổi trong mẫu giọng nói.
- Trợ lý ảo của bác sĩ: Chuyển bài phát biểu của bác sĩ thành ghi chú văn bản cho phép bác sĩ xem và phân tích nhiều bệnh nhân hơn trong ngày.
- Ứng dụng bên thứ ba:Trợ lý y tế và công cụ chăm sóc sức khỏe tích hợp nhận dạng giọng nói để tăng cường chức năng.
- Ô tô:
- Hệ thống trong ô tô: Nhận dạng giọng nói của người lái xe để điều chỉnh tùy chọn, truy cập điều hướng và điều khiển hệ thống thông tin giải trí mà không cần nhập thủ công.
- Trải nghiệm rảnh tay: Trả lời cuộc gọi, chuyển bài hát, trả lời tin nhắn hoặc nhận chỉ đường mà không cần phải rời khỏi vô lăng; điều này không chỉ tăng độ an toàn trên đường mà còn mang lại trải nghiệm lái xe tốt hơn.
- Pháp lý và pháp y:
- Nhận dạng giọng nói: Được sử dụng trong điều tra pháp lý để xác định người nói trong bản ghi âm.
- Giám sát an ninh: Tăng cường các biện pháp an ninh bằng cách xác định cá nhân thông qua giọng nói trong hệ thống giám sát.
- Báo cáo tòa án:Công nghệ nhận dạng giọng nói tiên tiến được sử dụng để phiên âm pháp lý chính xác trong các phiên tòa và lời khai, cải thiện hiệu quả và độ chính xác so với các phương pháp ghi chép phiên tòa truyền thống.
- Giải Trí:
- chơi game: Cá nhân hóa trải nghiệm chơi trò chơi bằng cách nhận dạng giọng nói của người chơi.
- Thiết bị truyền thông: Xác định người dùng để tùy chỉnh đề xuất nội dung và hồ sơ trên các thiết bị phát trực tuyến.
- Viễn thông:
- Truyền thông an toàn: Đảm bảo các kênh liên lạc an toàn bằng cách xác minh danh tính của người tham gia các cuộc gọi bí mật.
- Giao diện giọng nói: Cho phép tương tác tự nhiên, đàm thoại trong AI tạo sinh và các thiết bị thông minh, giúp trải nghiệm của người dùng trực quan hơn.
- Nhiều thiết bị và thiết bị di động:Công nghệ nhận dạng giọng nói hoạt động liền mạch trên nhiều thiết bị, bao gồm thiết bị di động và điện thoại Android, hỗ trợ năng suất và trải nghiệm của người dùng khi đang di chuyển.
- Phần mềm nhận dạng công việc:Phần mềm nhận dạng hiện đại hỗ trợ nhiều ngôn ngữ khác nhau, cung cấp hỗ trợ đa ngôn ngữ và tương thích với các thiết bị di động và nhiều nền tảng khác nhau để điều khiển bằng giọng nói.
- Phần mềm nhận dạng giọng nói hoạt động:Phần mềm nhận dạng giọng nói hoạt động trên nhiều nền tảng khác nhau, hỗ trợ nhiều ngôn ngữ và tích hợp với các ứng dụng của bên thứ ba để nâng cao chức năng.
- Hỗ trợ cho nhiều ngôn ngữ khác nhau:Hệ thống nhận dạng giọng nói hiện đại có thể chuyển đổi giữa các ngôn ngữ, phương ngữ và giọng khác nhau, giúp chúng trở nên linh hoạt khi sử dụng trên toàn cầu.
Ví dụ về công nghệ nhận dạng giọng nói
- Táo Siri: Hãy tưởng tượng trong túi bạn có một người bạn hóm hỉnh, hiểu biết, luôn sẵn sàng giúp đỡ. Đó là Siri dành cho bạn. Cho dù bạn đang vội đến một cuộc họp và cần gửi một tin nhắn nhanh hay bạn đang bận rộn với việc làm bánh quy và cần đặt hẹn giờ, Siri sẽ ở đó, nhận dạng giọng nói của bạn và phản hồi một cách cá tính. Giống như có một trợ lý riêng biết rất rõ về bạn, họ gần như có thể kết thúc câu nói của bạn.
- AmazonAlexa: Hãy tưởng tượng bạn bước vào nhà sau một ngày dài và nói: “Alexa, tôi đã về rồi”. Đột nhiên, danh sách nhạc thư giãn yêu thích của bạn bắt đầu phát, ánh đèn mờ đi theo khung cảnh buổi tối ưa thích của bạn và Alexa nhắc bạn về chương trình mà bạn muốn xem. Giống như ngôi nhà của bạn mang đến cho bạn một cái ôm an ủi, riêng tư mỗi khi bạn trở về.
- Trợ lý Google: Hãy coi Trợ lý Google như người bạn toàn năng của bạn. Cho dù bạn đang thắc mắc về thời tiết, cần giải quyết một cuộc tranh luận thân thiện hay muốn kiểm soát ngôi nhà thông minh của mình, nó sẽ ở đó, nhận dạng giọng nói của bạn và điều chỉnh phản hồi của giọng nói đó dành riêng cho bạn. Giống như có một người bạn siêu thông minh luôn sẵn lòng giúp đỡ và không bao giờ mệt mỏi trước những câu hỏi của bạn.
- Nuance Dragon Nói một cách tự nhiên: Hãy tưởng tượng bạn có thể trút những suy nghĩ của mình lên giấy nhanh như bạn có thể nói ra. Đó chính là sự kỳ diệu của Dragon NaturalSpeaking. Đối với một tiểu thuyết gia đang viết cuốn sách bán chạy tiếp theo của họ hoặc một bác sĩ cập nhật hồ sơ bệnh nhân, điều đó giống như có một người ghi chép siêu hiệu quả, không bao giờ mệt mỏi, người có thể hiểu từng từ, giọng điệu và sắc thái trong giọng nói của bạn. Đó không chỉ là gõ phím – nó còn giải phóng suy nghĩ của bạn.
- Microsoft Cortana: Cortana giống như có một nhà tổ chức cá nhân luôn đi trước một bước. Hãy tưởng tượng bản thân bạn vào một buổi sáng thứ Hai bận rộn và Cortana xen vào: “Dựa trên giọng nói của bạn, bạn có vẻ hơi căng thẳng. Tôi có nên sắp xếp lại các cuộc họp ít khẩn cấp hơn của bạn vào cuối tuần này không? Nó không chỉ là quản lý lịch trình của bạn; đó là việc có một đồng minh kỹ thuật số hiểu được các sắc thái trong giọng nói của bạn và giúp một ngày của bạn trở nên suôn sẻ hơn.